
Introducción
De la cuenta única al entorno “Enterprise”
En este articulo te cuento como construí una Landing Zone en AWS para un entorno multi-cuenta utilizando Amazon Control Tower y Terraform, te explicó porque lo hice, cómo lo hice y las decisiones que tomé en el camino.
Objetivo
Mi objetivo con este proyecto no era crear un laboratorio rápido para luego destruirlo, sino implementar una plataforma base en AWS que me sirva para alojar futuros proyectos personales de aprendizaje que pueda incluir en mi portafolio técnico, así como incorporar las cuentas aisladas que he creado con el tiempo y en donde tengo desplegados algunos servicios que uso de forma “productiva” (como algún bucket S3 el hosted zone en Route53 de mi propio dominio personal).
Requisitos principales
Antes de iniciar el proyecto tenia tres requisitos claros que quería mantener, a primera vista puede parecer que se contraponen uno con otro, pero cada uno tiene su razón de ser,espero que con las decisiones de arquitectura que tomé haya logrado conciliarnos.
El primero es que la plataforma tenía que parecerse lo más posible a un entorno “enterprise” real. Mi intención es desplegar cargas de trabajo que cumplan los criterios que se les exigen a una aplicación en una empresa, los mismos que propone el AWS Well-Architected Framework: confiabilidad, seguridad, eficiencia de desempeño y excelencia operativa. Para eso, la plataforma debía ofrecer al menos cuatro capacidades:
- Separación de ambientes: ambientes bajos (desarrollo y pruebas) aislados de los productivos, cada uno en su propia cuenta.
- Gobernanza preventiva: controles a nivel de organización que sirvan de guardrails que impidan ciertas acciones sin importar la cuenta y quien la esta operando.
- Detección de desvíos: mecanismos que identifiquen cuando un recurso o la propia landing zone se aparta de la configuración esperada (drift).
- Auditoría centralizada: registro de la actividad y la configuración de todas las cuentas en un solo lugar.
El segundo requisito corresponde a otro pilar del Well-Architected Framework, la optimización de costos. La plataforma debía mantener con una disciplina de costos estricta, en especial en su costo base, es decir lo que cuesta solo por existir y sin cargas de trabajo desplegadas. Dado que el uso por ahora es personal y en presupuesto sale de mi bolsillo, el objetivo era mantenerme por debajo de USD 10 al mes.
Previamente ya había experimentado con Control Tower y a las malas descubrí que AWS Config puede generar costos inesperados si no se configura adecuadamente, En esta ocasión espero que esas lecciones aprendidas me sirvan de algo.
El tercer requisito es lo contrario al primero, ya que también necesitaba un espacio aislado para pruebas rápidas y laboratorios sencillos, el cual tuviera una gobernanza mínima, lo que significa menos reglas que en un entorno empresarial (sin varios ambientes ni etiquetado obligatorio, etc.) pero con los mismos límites de seguridad y costo que protegen al resto de la organización. Un ambiente sandbox que me dé libertad para experimentar, pero sin generar una factura inesperada.
¿Qué es una Landing Zone?
Por lo general las organizaciones y las personas inician sus primeros pasos en la nube de AWS desplegando servicios en cuentas aisladas, probablemente sin ningún tipo de estandarización o gobernanza.
Un paso natural y casi obligatorio cuando el uso de los servicios de nube empieza a proliferar en la organización y varios equipos empiezan a crear cuentas y desplegar recursos es estandarizar, agrupar todas las cuentas individuales bajo una misma organización, e implementar mecanismos de control y gobernanza que permitan el despliegue rápido de aplicaciones pero en un ambiente ordenado, escalable y seguro.
En el momento que la organización decide adoptar formalmente su camino a la nube, se introduce el concepto de Landing Zone, en donde la idea es que sirva de zona de aterrizaje para las aplicaciones y cargas de trabajo dentro de un entorno AWS multi-cuenta controlado, seguro y con una arquitectura adecuada.
AWS Control Tower y Terraform
Para implementar esta Landing Zone, utilicé el servicio de AWS Control Tower, el cual permite orquestar de forma automatizada servicios clave como AWS Organizations, AWS Service Catalog e IAM Identity Center, aplicando controles continuos (guardrails) que evitan desviaciones (drifts) de seguridad.
Uno de los principales beneficios de implementar Control Tower es que permite aplicar controles (llamados guardrails) los cuales ayudan a evitar que existan drifts o desvíos entre las cuentas. AWS Control Tower permite adherirse de forma fácil a estándares corporativos, ayuda a establecer una base para el cumplimiento de requerimientos regulatorios y seguir las mejores prácticas de arquitectura cloud.
Cabe mencionar que AWS Control Tower es la forma estándar de crear una Landing Zone en AWS; sin embargo landing zones personalizadas para casos muy específicos, lo que se recomienda es partir de Control Tower y evolucionar si hace falta.
Toda la infraestructura que abarca la organización la gestioné con Terraform, por ejemplo las Service Control Policies (SCPs) y los componentes de red transversales, como la VPC de la cuenta Networking, la cual actúa como un hub, así como las conexiones de peering. De este modo cada cambio queda versionado y es revisable antes de aplicarse.
También creé módulos reutilizables (por ejemplo, una VPC base para las cuentas tipo Workload y otro para las tipo Sandbox) para que, cuando haga falta crear recursos en una cuenta nueva, todas partan del mismo estándar y no de configuraciones hechas a mano.
Los recursos administrados por Control Tower quedaron deliberadamente fuera de Terraform para evitar drift en la landing zone.
Requisitos previos
Antes de desplegar Control Tower, partí de una cuenta standalone de AWS, es decir, una cuenta que no pertenecía a ninguna organización. Esa cuenta se convirtió en la cuenta de administración (management account) de la nueva organización de AWS.
En esta cuenta configuré lo siguiente:
- MFA para el usuario root.
- Un usuario IAM temporal con MFA y access keys, para trabajar desde la CLI durante la configuración inicial. Más adelante lo reemplacé por IAM Identity Center y un usuario break-glass dedicado, porque no conviene mantener credenciales de larga duración en la cuenta de administración.
- Control de costos antes de desplegar nada:
- Activé el acceso de usuarios y roles IAM a la información de facturación.
- Creé un presupuesto en AWS Budgets.
- Habilité las alertas de facturación de CloudWatch y creé una alarma como respaldo del presupuesto.
Definiciones iniciales para Control Tower
Con la cuenta de administración con todas las de la ley, tenía que tomar algunas decisiones antes de ejecutar el asistente de Control Tower. Algunas no se pueden cambiar después sin rehacer la landing zone.
Regiones
- Región principal (home region):
us-east-1. Es la región donde Control Tower despliega sus recursos base. Conviene elegirla con cuidado, porque no se puede cambiar después sin desmantelar la landing zone. - Regiones gobernadas adicionales: ninguna por ahora. Si más adelante monto un laboratorio de Disaster Recovery en una región alterna y quiero que Control Tower también la gobierne, la agregaré entonces.
- Denegar el uso de regiones no gobernadas: lo activé para bloquear cualquier despliegue de recursos fuera de
us-east-1. Así evito costos inesperados y recursos olvidados en otras regiones.
Cuentas de integración de servicios
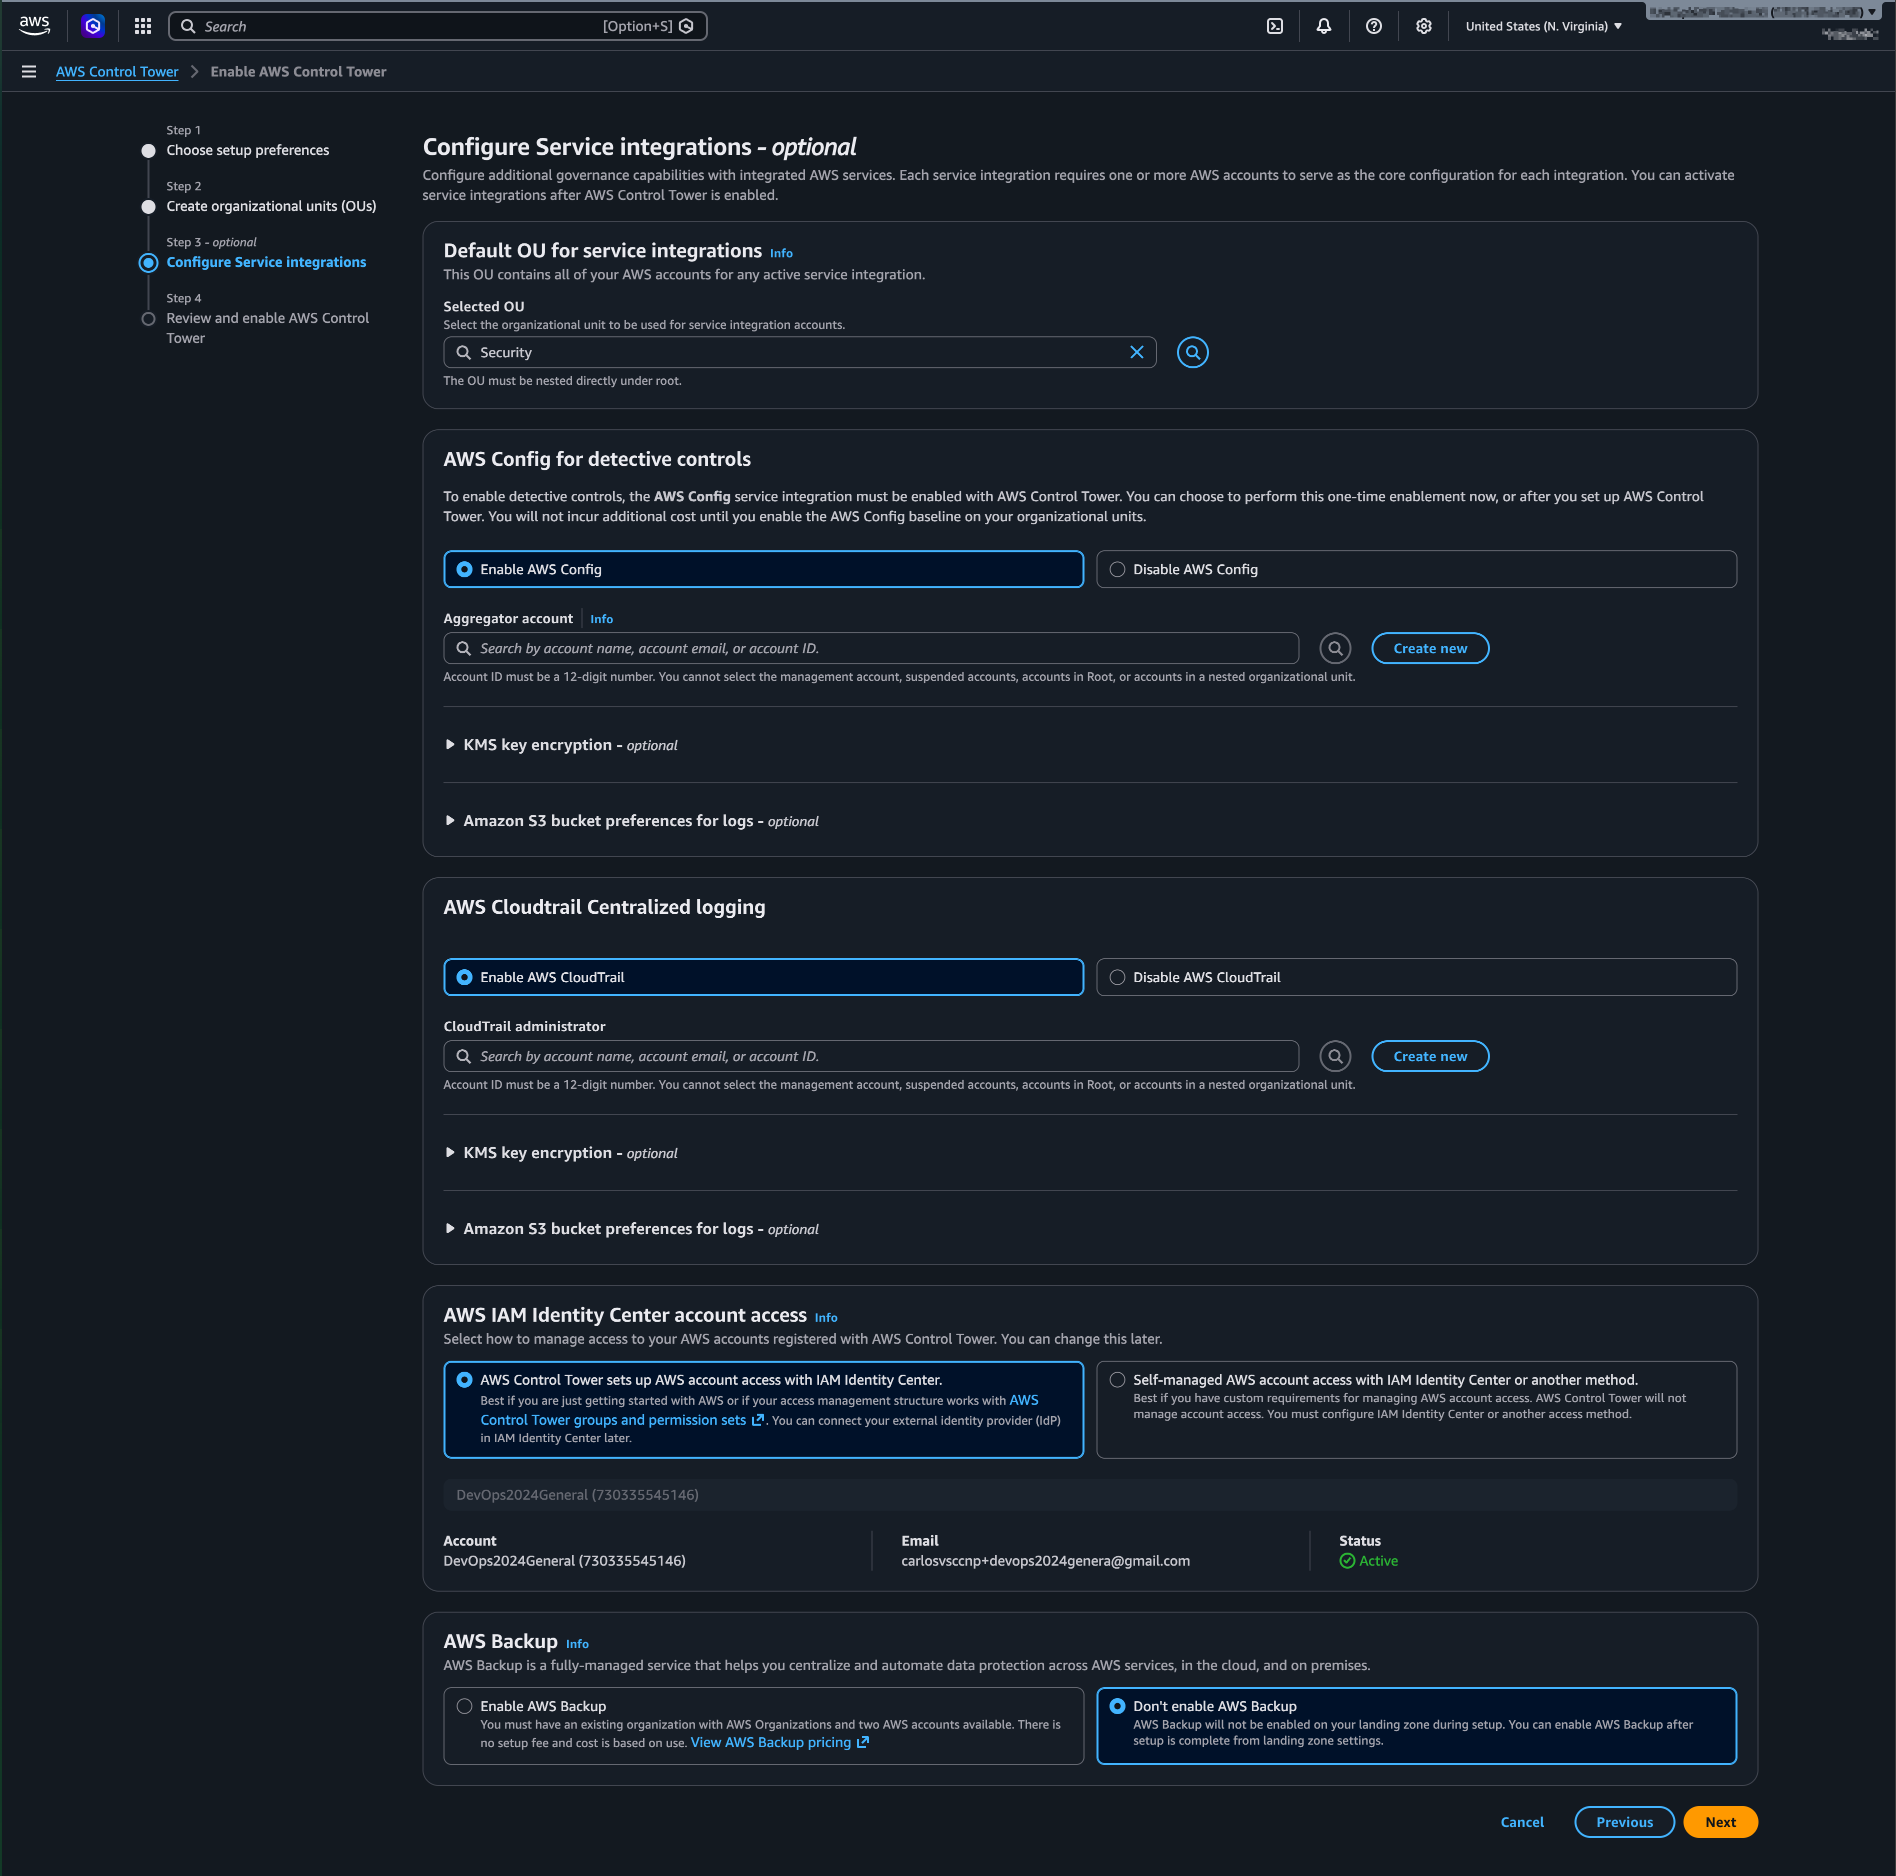
Control Tower 4.0 pide dos cuentas compartidas, que llama service integration accounts (documentación ):
- CloudTrail administrator account: centraliza los logs de CloudTrail de toda la organización.
- Config Aggregator account: agrega la información de AWS Config de todas las cuentas de la organización.
Estas cuentas pueden crearse durante el asistente o pueden ser cuentas existentes. El asistente sugiere nombres, pero puedes usar los que quieras. Ambas deben estar en la misma OU: el asistente recomienda una OU llamada Security, aunque puedes elegir otra existente o darle otro nombre.
Note: > Por costumbre de versiones anteriores, a mi CloudTrail administrator account le puse
LogArchive. Te recomiendo usar los nombres que propone el asistente para mantener la nomenclatura de Control Tower 4.0. Así tu landing zone coincide con la documentación actual.
- Un correo electrónico único por cuenta: AWS exige una dirección distinta para el usuario root de cada cuenta. En lugar de crear buzones nuevos, usé alias con el signo
+(por ejemplo,usuario+cloudtrail@gmail.com). Todos los correos llegan a la misma bandeja.
Tip: > Si vienes de guías de versiones anteriores de Control Tower: la 4.0 ya no usa las cuentas Log Archive y Audit. En su lugar, el asistente pide una CloudTrail administrator account y una Config Aggregator account.
Decisiones de Arquitectura
Además de las definiciones iniciales, tomé una serie de decisiones arquitectónicas que determinaron cómo se implementó la Landing Zone. Estas decisiones se documentaron en el formato estándar Architecture Decision Record (ADR) y están disponibles en el repositorio del proyecto, en la sección de adr .
Estructura de OUs
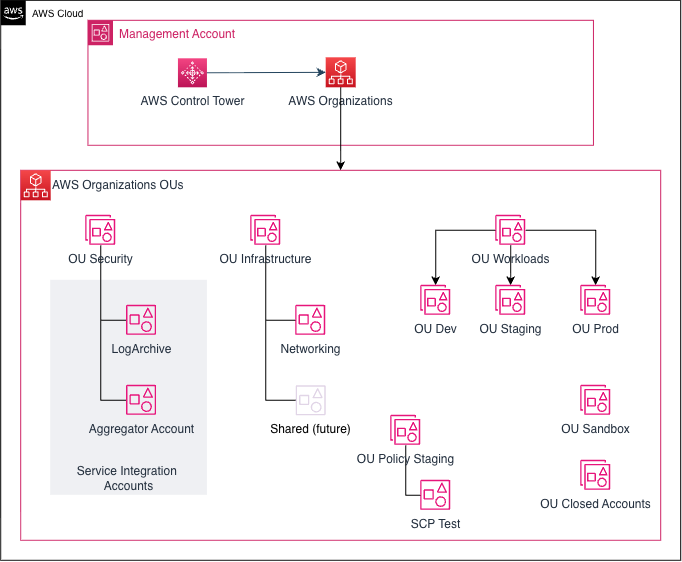
ADR-001: Organizational Units (OU)
- Ademas de la
OU Securitypara las cuentas de servició , decidí crear 2 OUs de nivel uno para desplegar cuentas de usuarios o cargas de trabajo:OU WorkloadyOU Sandbox. - En la
OU Worklodsviviran cuentas de proyectos tipo empresarial en donde según descrito en los Requisitos principales se espera un entorno multi-ambiente, es por eso que se crearon tres OUs separadas para cada uno:Dev,StagingyProd. - En la
OU Sandboxira cuentas donde pienso desplegar pruebas o proyectos simples donde no se requiere la rigurosidad de una ambiente empresarial. - También crearé una OU llamada
Infrastructurecuyo objetivo es alojar cuentas para servicios transversales como la cuenta deNetworkingla cual esta destinada a los servicios de conectividad centralizada (más detalle en Networking Centralizado ). - Adicionalmente se contemplan otras dos OUs:
- Policy Staging: Destinada para una cuenta especial para hacer pruebas de SCs de manera aislada sin afectar toda la organización.
- ClosedAccounts: Aqui se colocarán todas las cuentas que han sido borradas y aún esan en proceso de que AWS configure su borrado completamente, el cual toma alrededor de 90 dias.
Árbol final de la estructura de OUs para la Landing Zone:
| |
Cuentas base o fundacionales
ADR-002 — Cuentas fundacionales
La landing zone se apoya en cuentas con un rol específico. Las agrupé en tres categorías:
1. Cuentas de Control Tower (Security OU)
| Cuenta | Rol | Notas |
|---|---|---|
| Management | Root de la organización y de Control Tower | Cuenta principal nueva y limpia, creada solo para este proposito, sin cargas de trabajo u otros servicios. |
| LogArchive | CloudTrail administrator | Centraliza los logs de CloudTrail de toda la organización. |
| Aggregator | Config Aggregator | Consolida la información de AWS Config de todas las cuentas. |
2. Cuentas de infraestructura (Infrastructure OU)
| Cuenta | Rol |
|---|---|
| Networking | Hub de conectividad (VPC peering hub-and-spoke) |
| Shared Services | Reservada para servicios transversales; aún no creada |
3. Cuentas auxiliares
| Cuenta | Rol |
|---|---|
| SCP-test | Cuenta aislada para probar SCPs antes de aplicarlas (Policy Staging OU) |
| MyWebApp-dev | Primera cuenta Workload (Dev OU); valida el flujo completo de aprovisionamiento |
4. Cuentas cerradas
En el proceso de despliegue del Control Tower, cometí algunos errores o cambios de decision, lo que me llevo a tener dos cuentas que tuve que cerrar en el proceso: Audit y Networking (duplicada), estas cuentas las moví a la OU de ClosedAccounts esperando que transcurra el tiempo de 90 días requerido por AWS para darlas por cerradas por completo.
Con las cuentas definidas, el siguiente paso fue decidir qué guardrails aplicar sobre ellas.
Guardrails
ADR-003: Estrategia de guardrails
Control Tower ya viene con sus propios controles, pero ninguno resuelve lo que más me preocupaba: que un error o un descuido mío me genere una factura inesperada. Por eso definí tres Service Control Policies (SCPs) propias. Son pocas a propósito y la idea es que representen el tipo de controles típicos que puede tener una organización y cada una responde a un riesgo concreto de costo u orden.
| # | SCP | Aplicada a |
|---|---|---|
| 1 | Restringir tipos de EC2 (t2.micro, t3.micro, t3.small) | Dev, Staging, Sandbox |
| 2 | Denegar creación de Transit Gateway | Todas las OUs excepto Security — sin excepción ni para Networking |
| 3 | Tags obligatorios (Project + Environment) en EC2/RDS/S3 | Workloads (heredado por Dev/Staging/Prod) |
La primera limita los tipos de instancia EC2 a tres tamaños pequeños. Si alguien lanza por error una instancia grande, la política lo bloquea antes de que cueste dinero. La segunda impide crear un Transit Gateway. Este servicio cobra por hora y por cada GB que pasa por él, y como decidí conectar las cuentas con VPC Peering (lo explico más adelante), no quiero que aparezca uno por accidente. La tercera obliga a etiquetar con Project y Environment los recursos de EC2, RDS y S3, para saber siempre de qué proyecto y de qué ambiente es cada cosa cuando llegue el momento de revisar costos.
La política #1 está acotada a las cuentas de Dev, Staging y Sandbox, dado que se asume que en un entorno empresarial real los ambientes bajos y de pruebas no necesitan la misma carga computacional que un ambiente productivo.
La SCP #2 la amplié a toda la organización menos Security. Incluso la cuenta Networking queda sin excepción. Esto es para evitar desplegar un Transit Gateway por error, el cual genera costos fijos que en este momento no son justificables. Si en el futuro quiero desplegar un Transit Gateway, prefiero tener que cambiar la política de forma consciente y no que se cuele por un descuido o desconocimiento.
Cómo las probé
Antes de aplicar cada política a una OU real, la probé en la cuenta SCP-test, que vive en Policy Staging. El flujo fue siempre el mismo: adjuntar la política a esa OU, hacer una prueba que debía fallar y otra que debía funcionar, y luego desadjuntarla. Así me aseguraba de que bloqueaba lo que debía y nada más, sin arriesgar el resto de la organización.
Networking centralizado
ADR-004: Estrategia de networking
Con cuentas separadas por ambiente, tarde o temprano van a necesitar comunicarse entre sí, y había que decidir cómo conectarlas. La opción que usaría una empresa a escala es AWS Transit Gateway, que funciona como un punto central al que se conectan todas las VPCs. El problema es que cobra por hora y por cada GB de tráfico, y ese costo fijo no se justifica para una plataforma personal con un presupuesto de menos de USD 10 al mes. Por eso lo descarté, y de hecho lo bloqueé con la SCP #2.
En su lugar elegí VPC Peering con un diseño hub-and-spoke. Hay una cuenta Networking que actúa como centro (hub), y cada cuenta de workload se conecta a ella con su propia conexión de peering. El peering no tiene costo por hora, solo se paga el tráfico que lo atraviesa. La contrapartida es que el peering no es transitivo: dos cuentas conectadas al hub no pueden hablar entre ellas a través de él, y por eso no hay peering entre spokes. Lo acepté porque hoy no tengo ningún caso que lo necesite, y si aparece, se puede migrar a Transit Gateway sin rehacer el resto de la plataforma.
La cuenta Networking no es una cuenta de workloads, y eso me llevó a usar dos diseños de VPC distintos en lugar de uno solo. La del hub no tiene Internet Gateway ni subnets públicas reales: su trabajo es concentrar las conexiones de peering (y más adelante una VPN hacia un entorno on-premises), no exponer nada a internet. Las cuentas de workload sí usan una VPC estándar con subnets públicas, de aplicación y de datos. Este diseño lo empaqueté en un módulo de Terraform reutilizable, para que cada cuenta nueva parta del mismo estándar.
Sobre la salida a internet, por ahora no desplegué NAT Gateway. Las subnets privadas quedan sin ruta de salida, lo cual es deliberado porque también tiene un costo fijo por hora. Es una decisión que puedo revisar cuando una carga de trabajo realmente lo requiera.
Por último, definí un plan de direccionamiento IP jerárquico, con un bloque de red por función y pools de reserva por ambiente (Sandbox, Dev, Staging y Prod). Los pools tienen espacio para crecer, pero no significa que planee crear muchas cuentas por ambiente: es solo margen para no tener que renumerar después. Un error de direccionamiento es muy costoso de corregir, porque el rango principal de una VPC no se puede cambiar en caliente, y el peering exige que los rangos de las cuentas conectadas no se solapen. El plan completo lo explico en la sección 7.
ADR-005 — IaC con Terraform
- State en S3 en la cuenta management (decisión por costo, temporal, con ruta de migración documentada).
- Locking con el lockfile nativo de S3 (Terraform ≥ 1.10) → sin DynamoDB.
- Un solo backend/state, alcanzando cuentas miembro con provider aliases que asumen un rol cross-account.
- Lo gestionado por Control Tower queda fuera del state.
Despliegue con el asistente de Control Tower
Todo: ✍️ Recorrido pantalla por pantalla: una línea por captura indicando qué decisión se aplica en ella.
Regiones gobernadas:
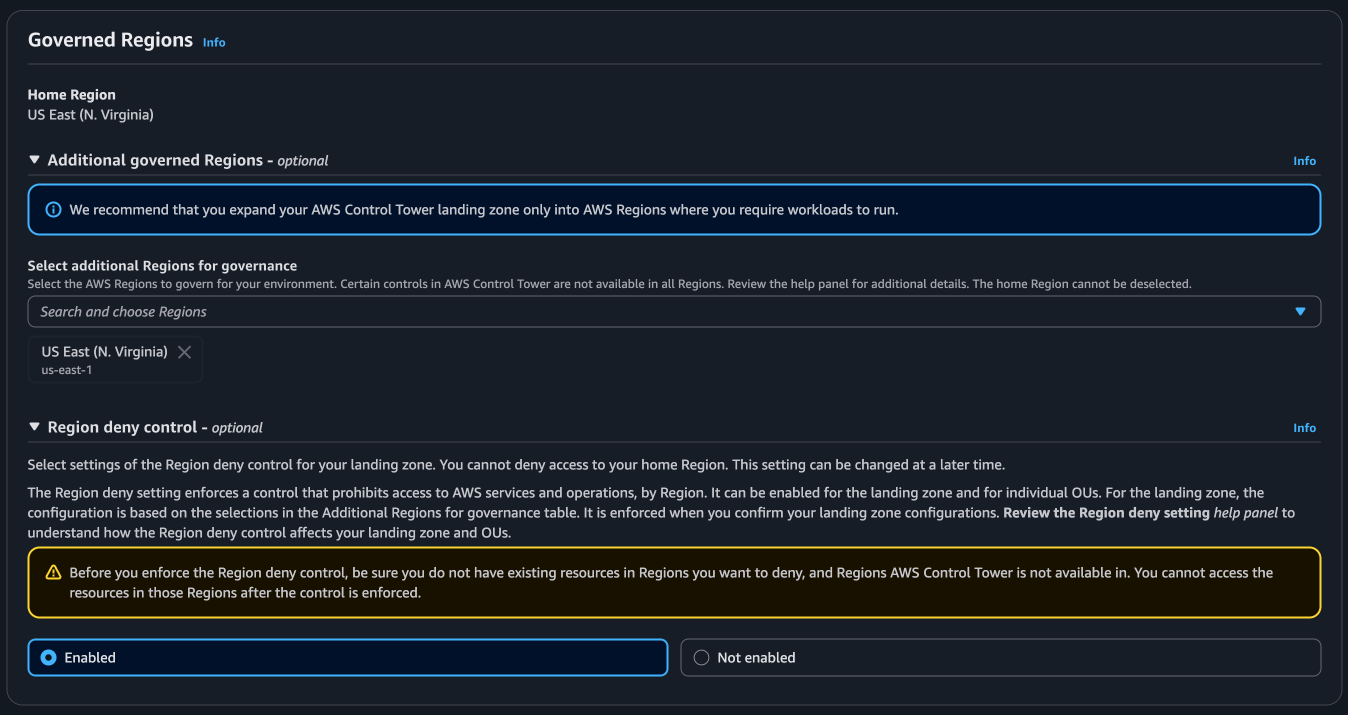
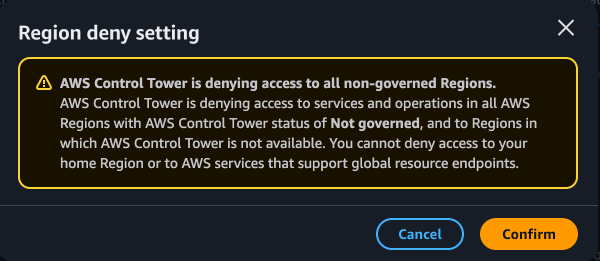
Denegación de regiones no gobernadas: al activarla, el asistente muestra esta advertencia: [TODO: resumir qué dice].
OU y cuentas de integración de servicios:
5. Ejecución, fase 1 — lo que hice a mano
Todo: ✍️ Escribe aquí
5.1 Cuenta management y control de costos
- Cuenta nueva desde cero, root con MFA.
- Acceso de IAM a la información de Billing, un Budget y una alarma de CloudWatch de respaldo (Budgets puede tardar horas en refrescar). Hecho el 2026-08-17, antes del wizard.
- Usuario IAM temporal con access keys para el bootstrap → luego eliminado y reemplazado (ver 5.4).
- Grabaste un video en OBS de esta parte. (¿Lo incluyes o enlazas?)
5.2 El wizard de Control Tower (2026-08-17) — no salió a la primera
- Una sesión expiró a mitad del wizard. Quedó creada una cuenta
Auditque luego cerraste. - En el reintento, CT v4.0 creó una cuenta nueva “Aggregator account” para cumplir ambos roles (Config aggregator + CloudTrail admin), además de
LogArchive. - Resultado: 3 cuentas miembro en vez de 2, con nombres distintos a los planeados. La
Auditcerrada quedó inerte, esperando los 90 días. - El wizard también creó una
SandboxOU por defecto — encajaba con el diseño, se quedó.
5.3 OUs adicionales y la cuenta de pruebas
- Creadas a mano: Infrastructure, Workloads, Dev, Staging, Prod, Policy Staging.
- Cuenta
SCP-testcreada con Account Factory dentro de Policy Staging.
5.4 Identidad y accesos — Identity Center + break-glass
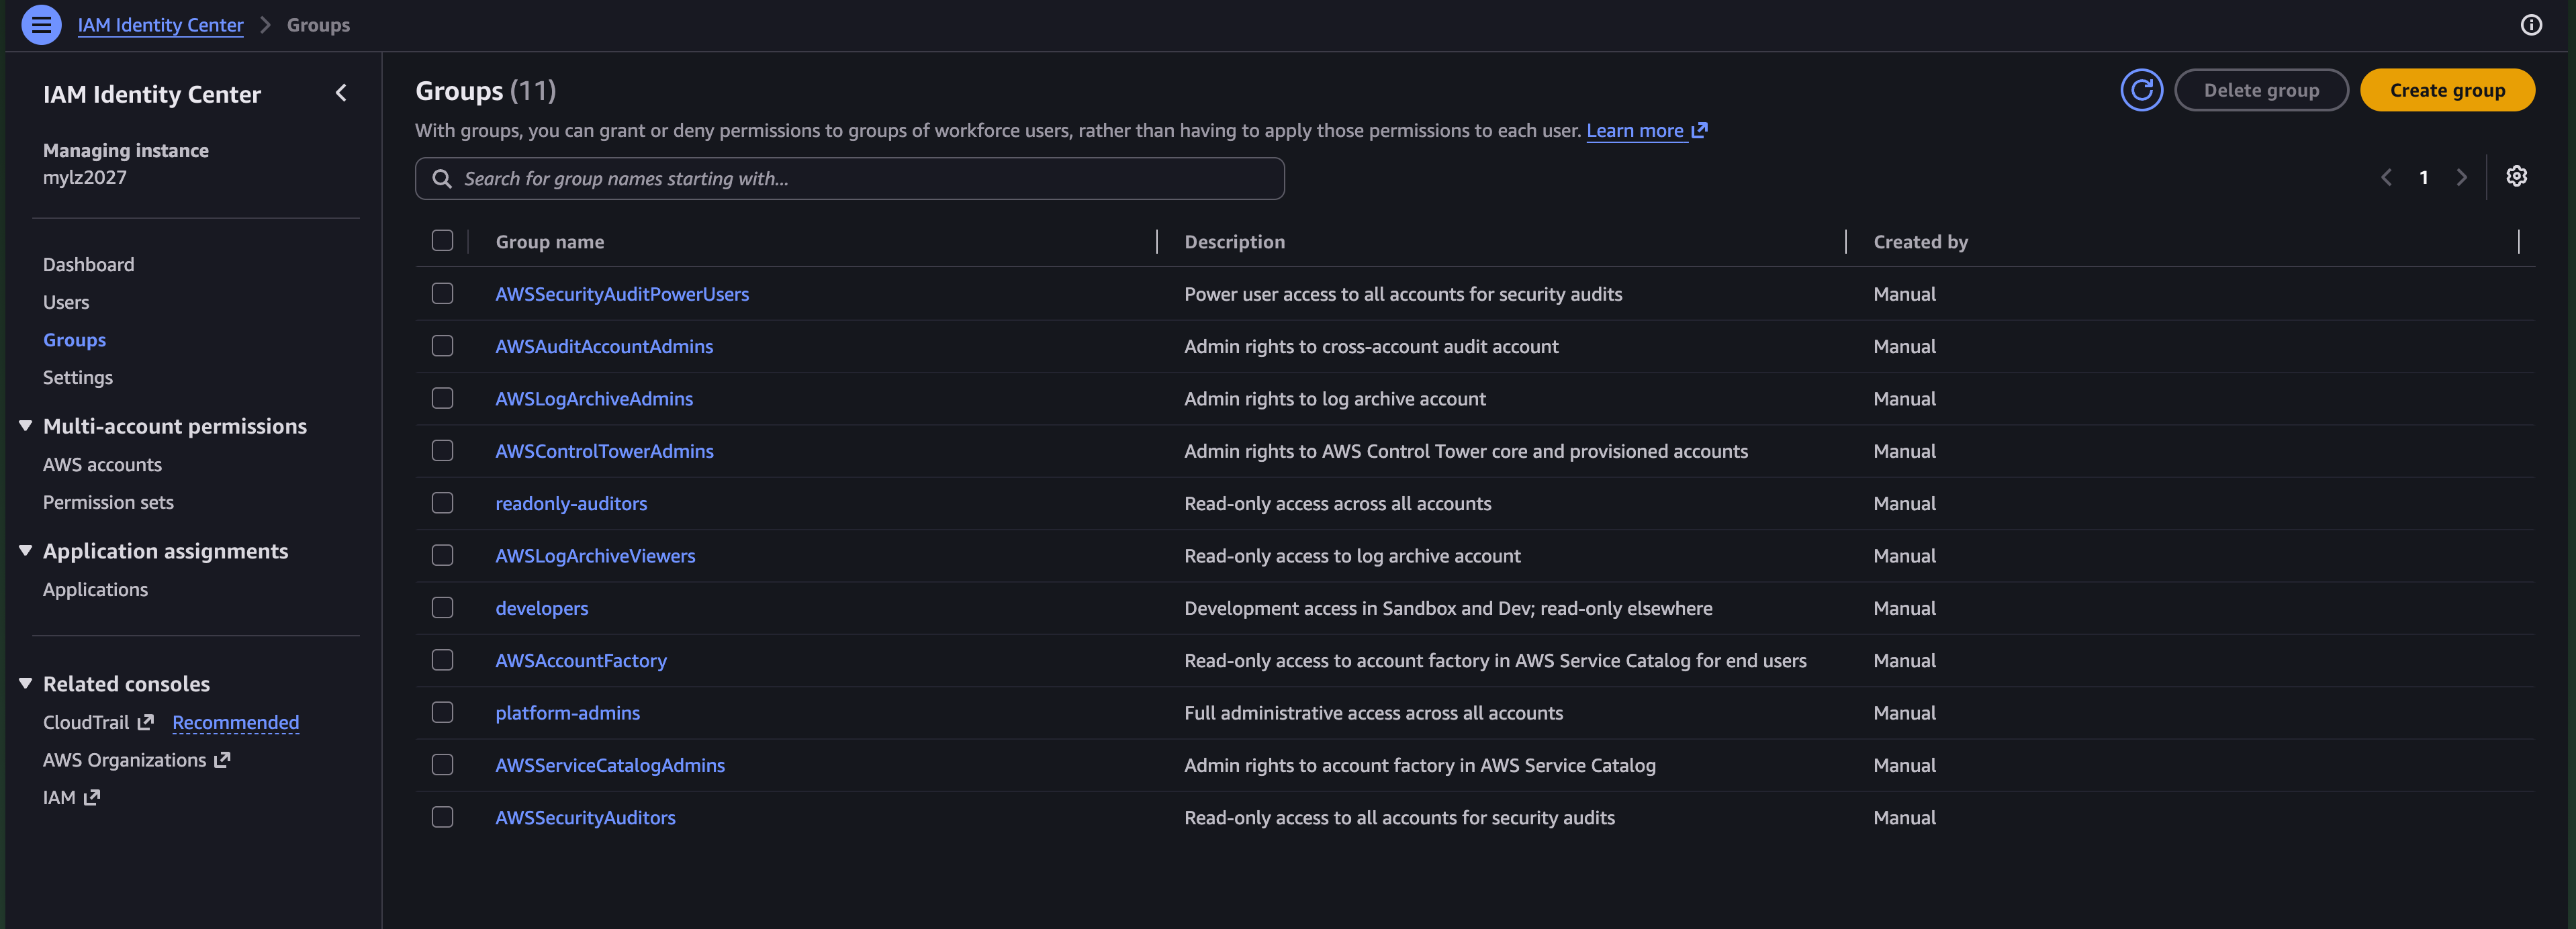
- Grupos = identidad funcional:
platform-admins,developers,readonly-auditors.
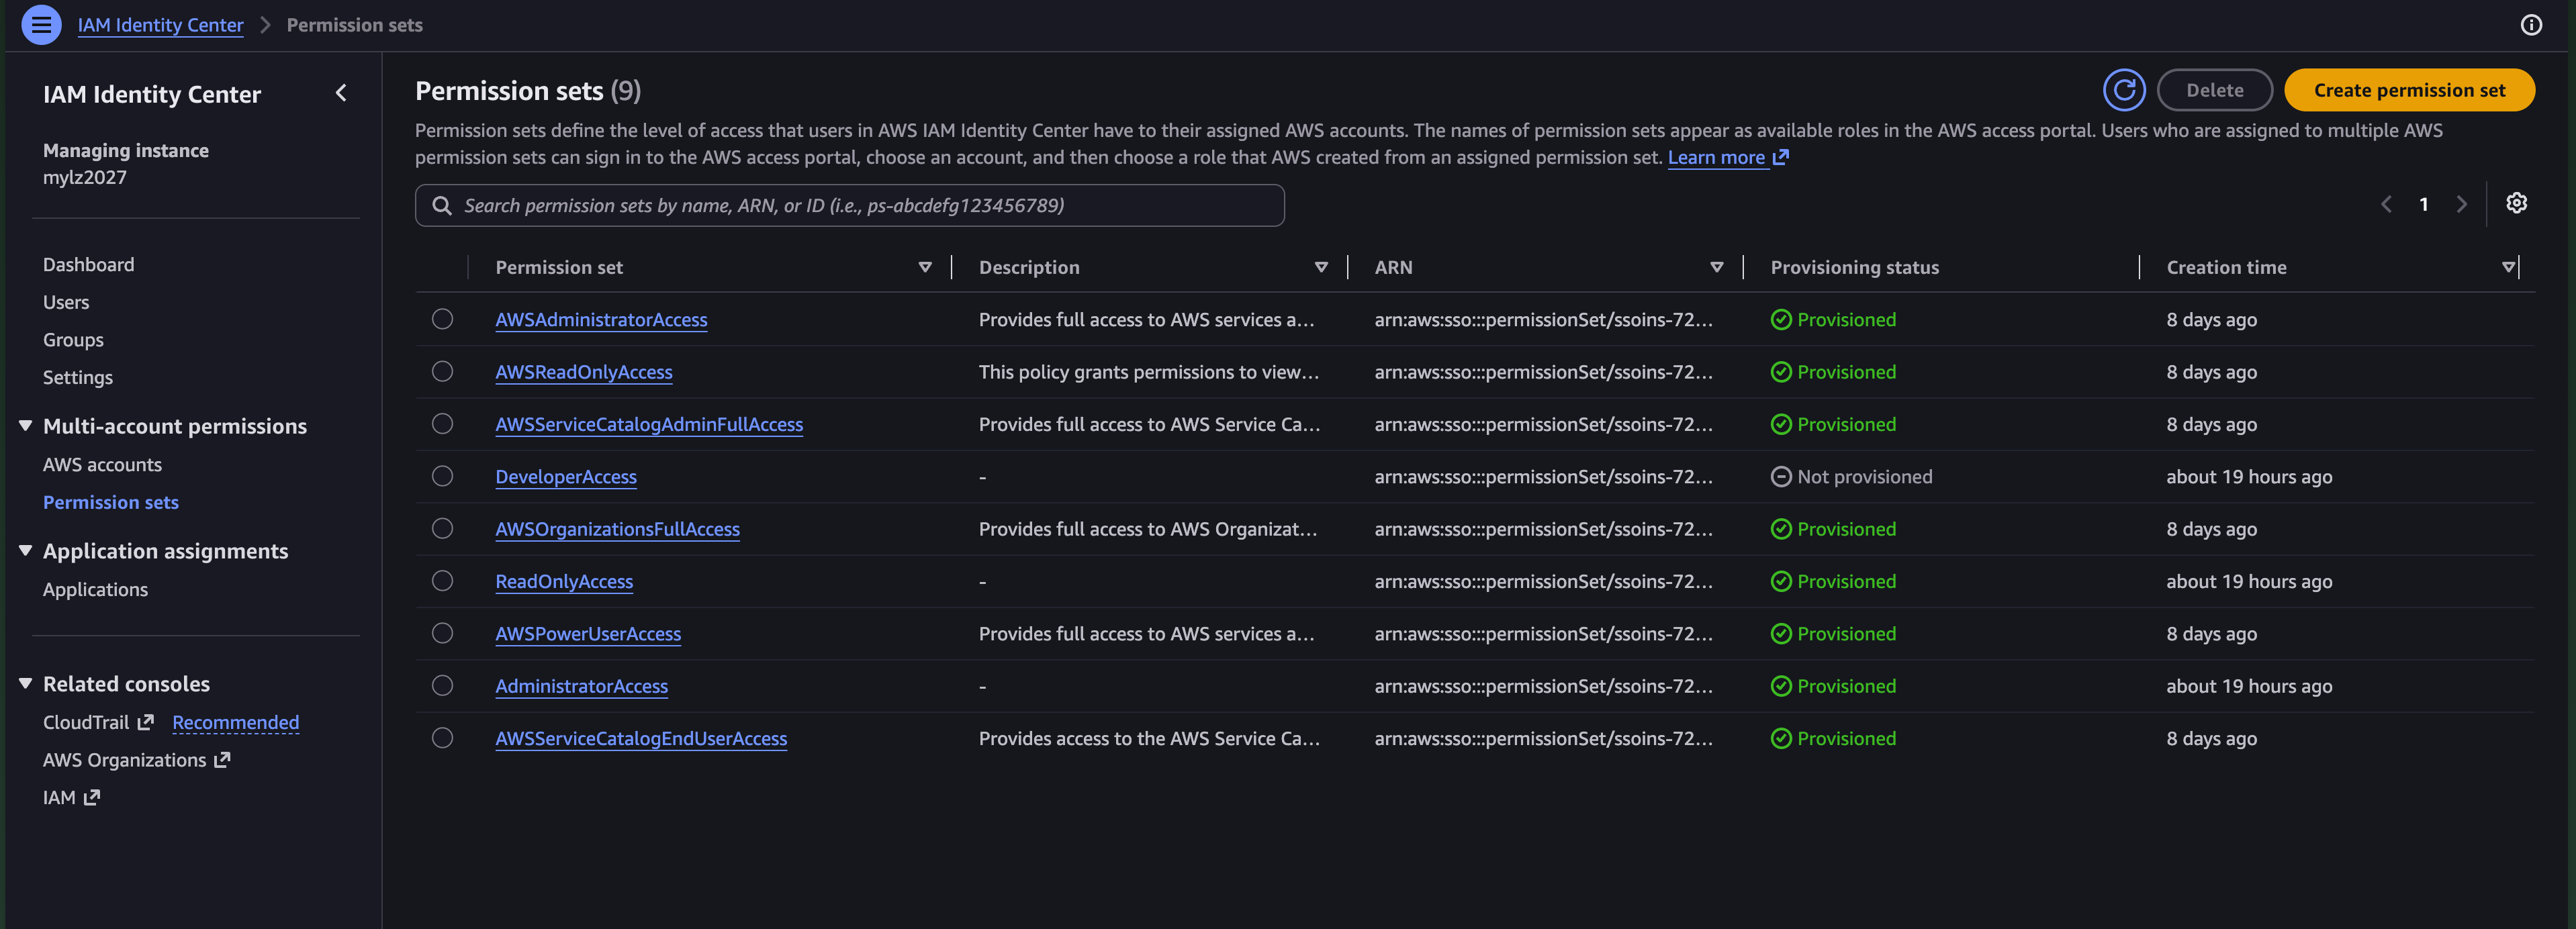
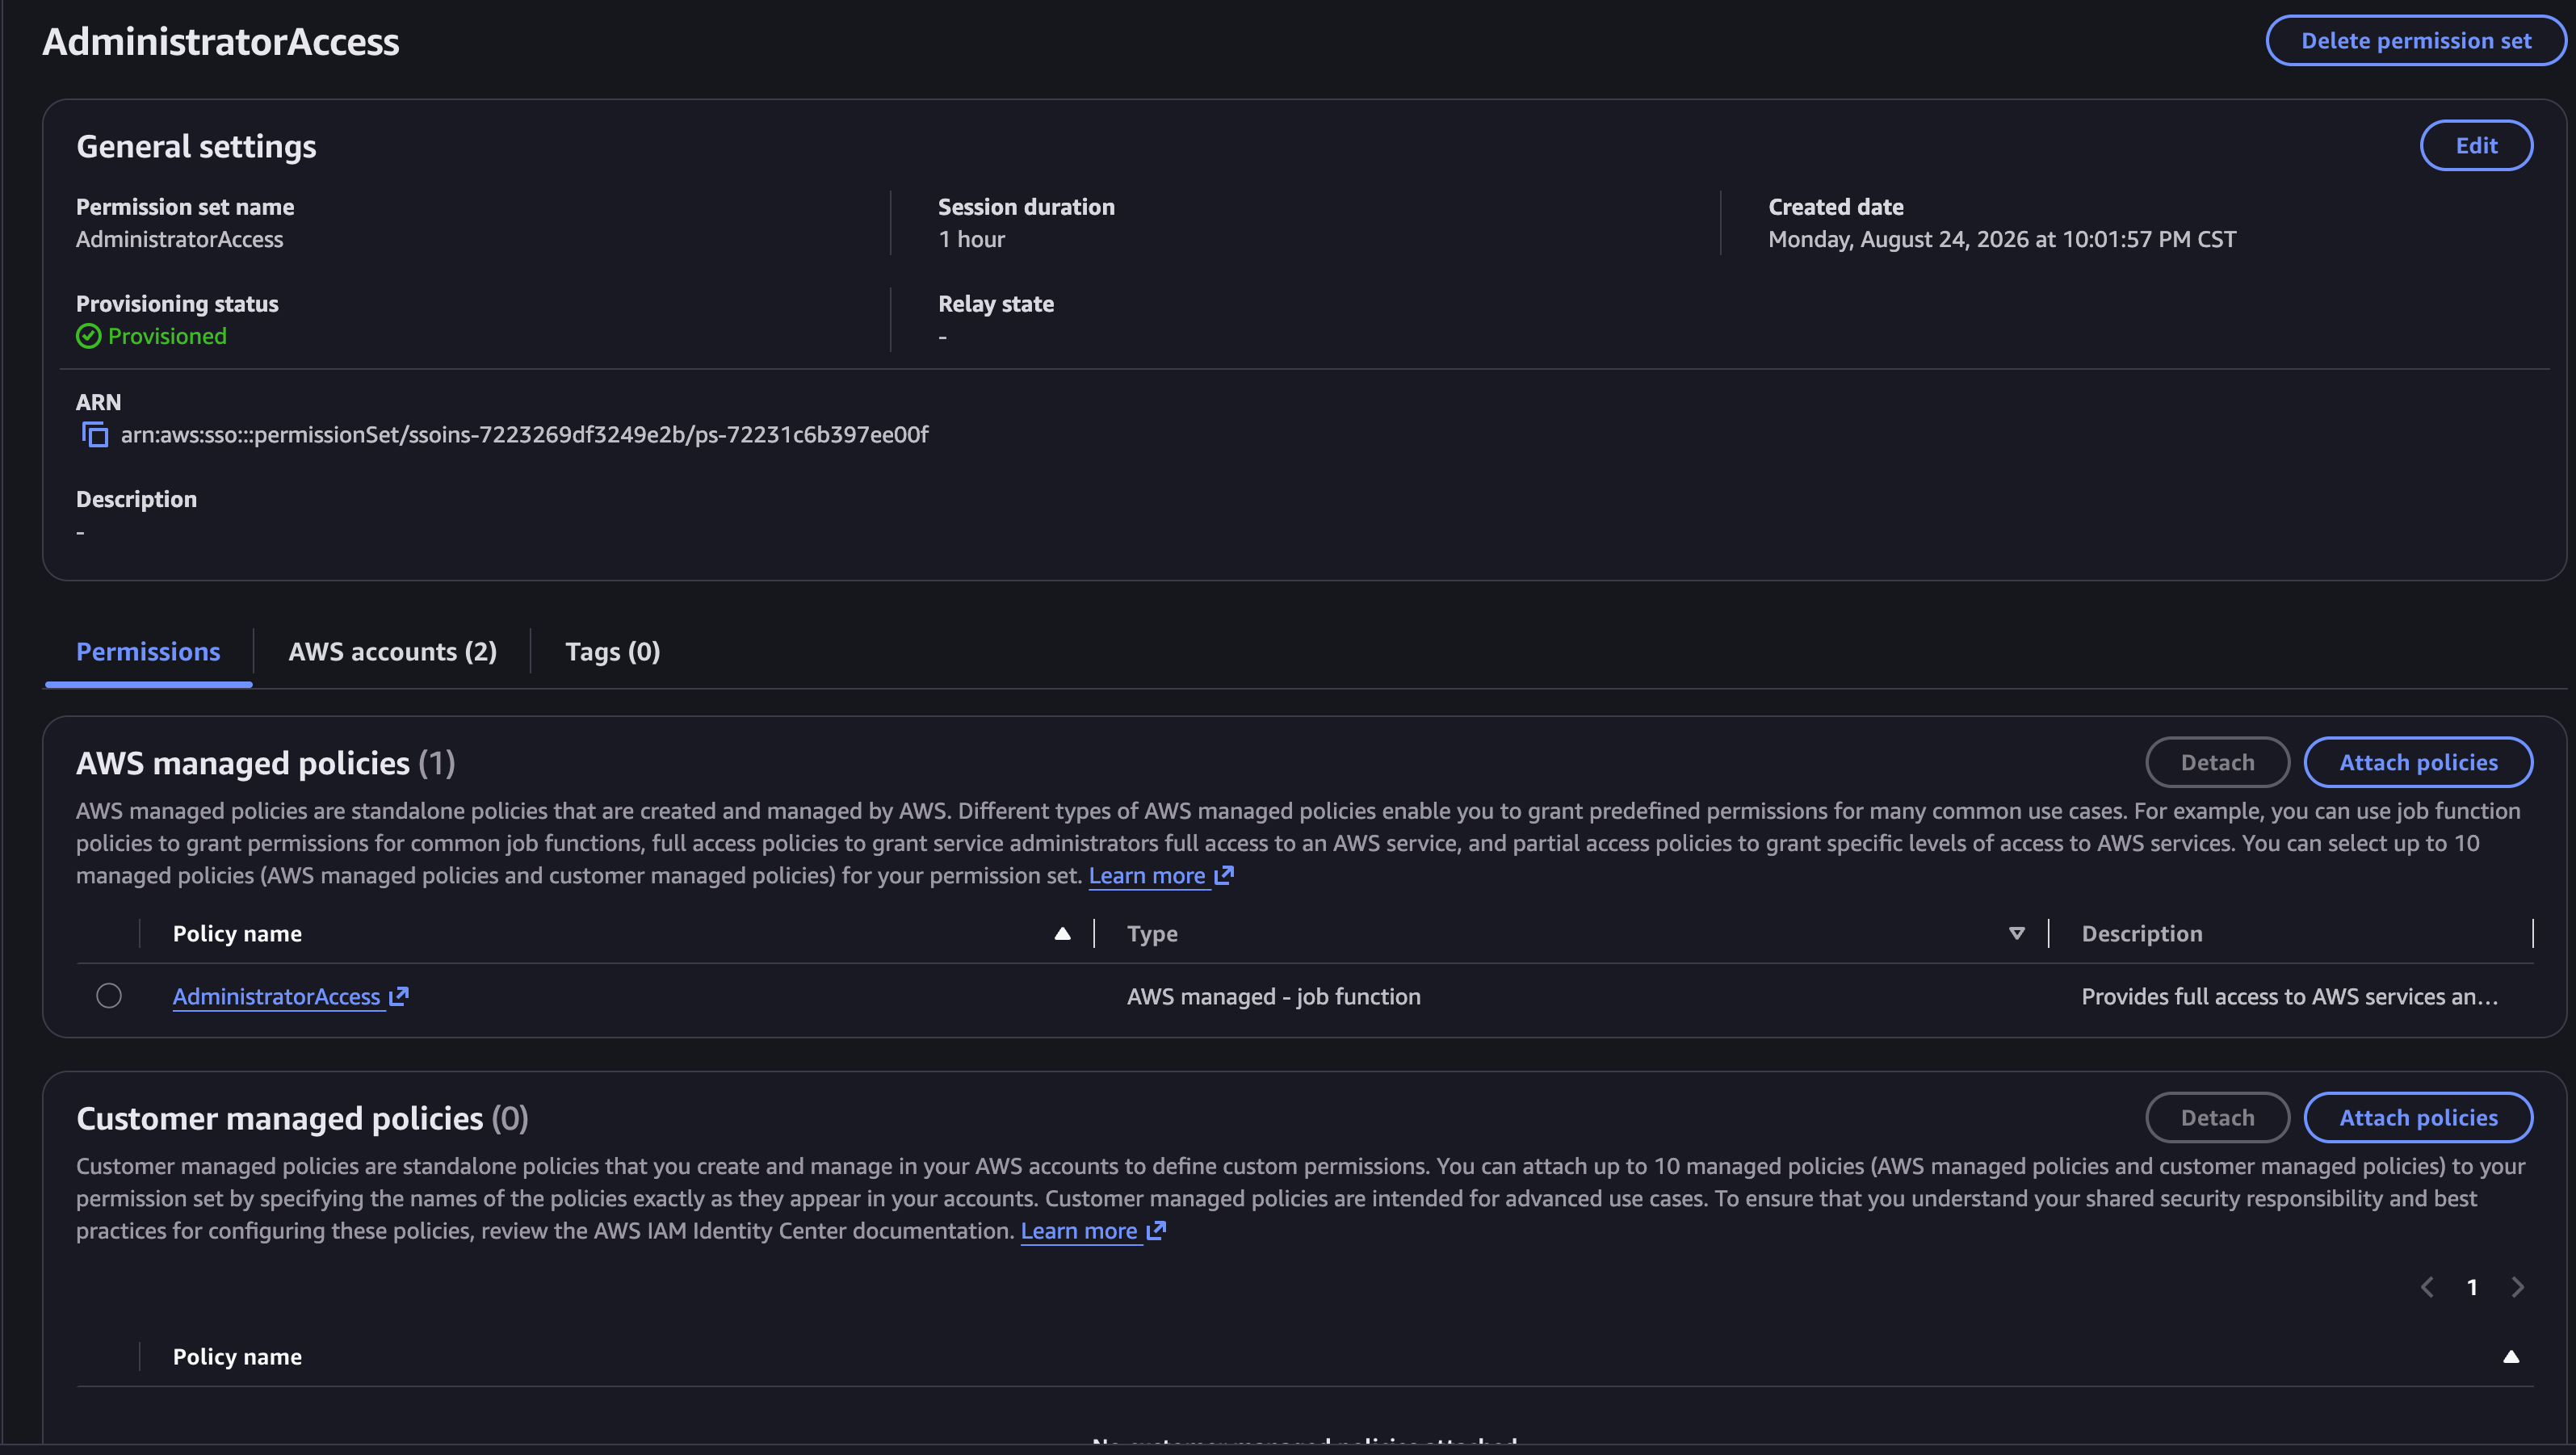
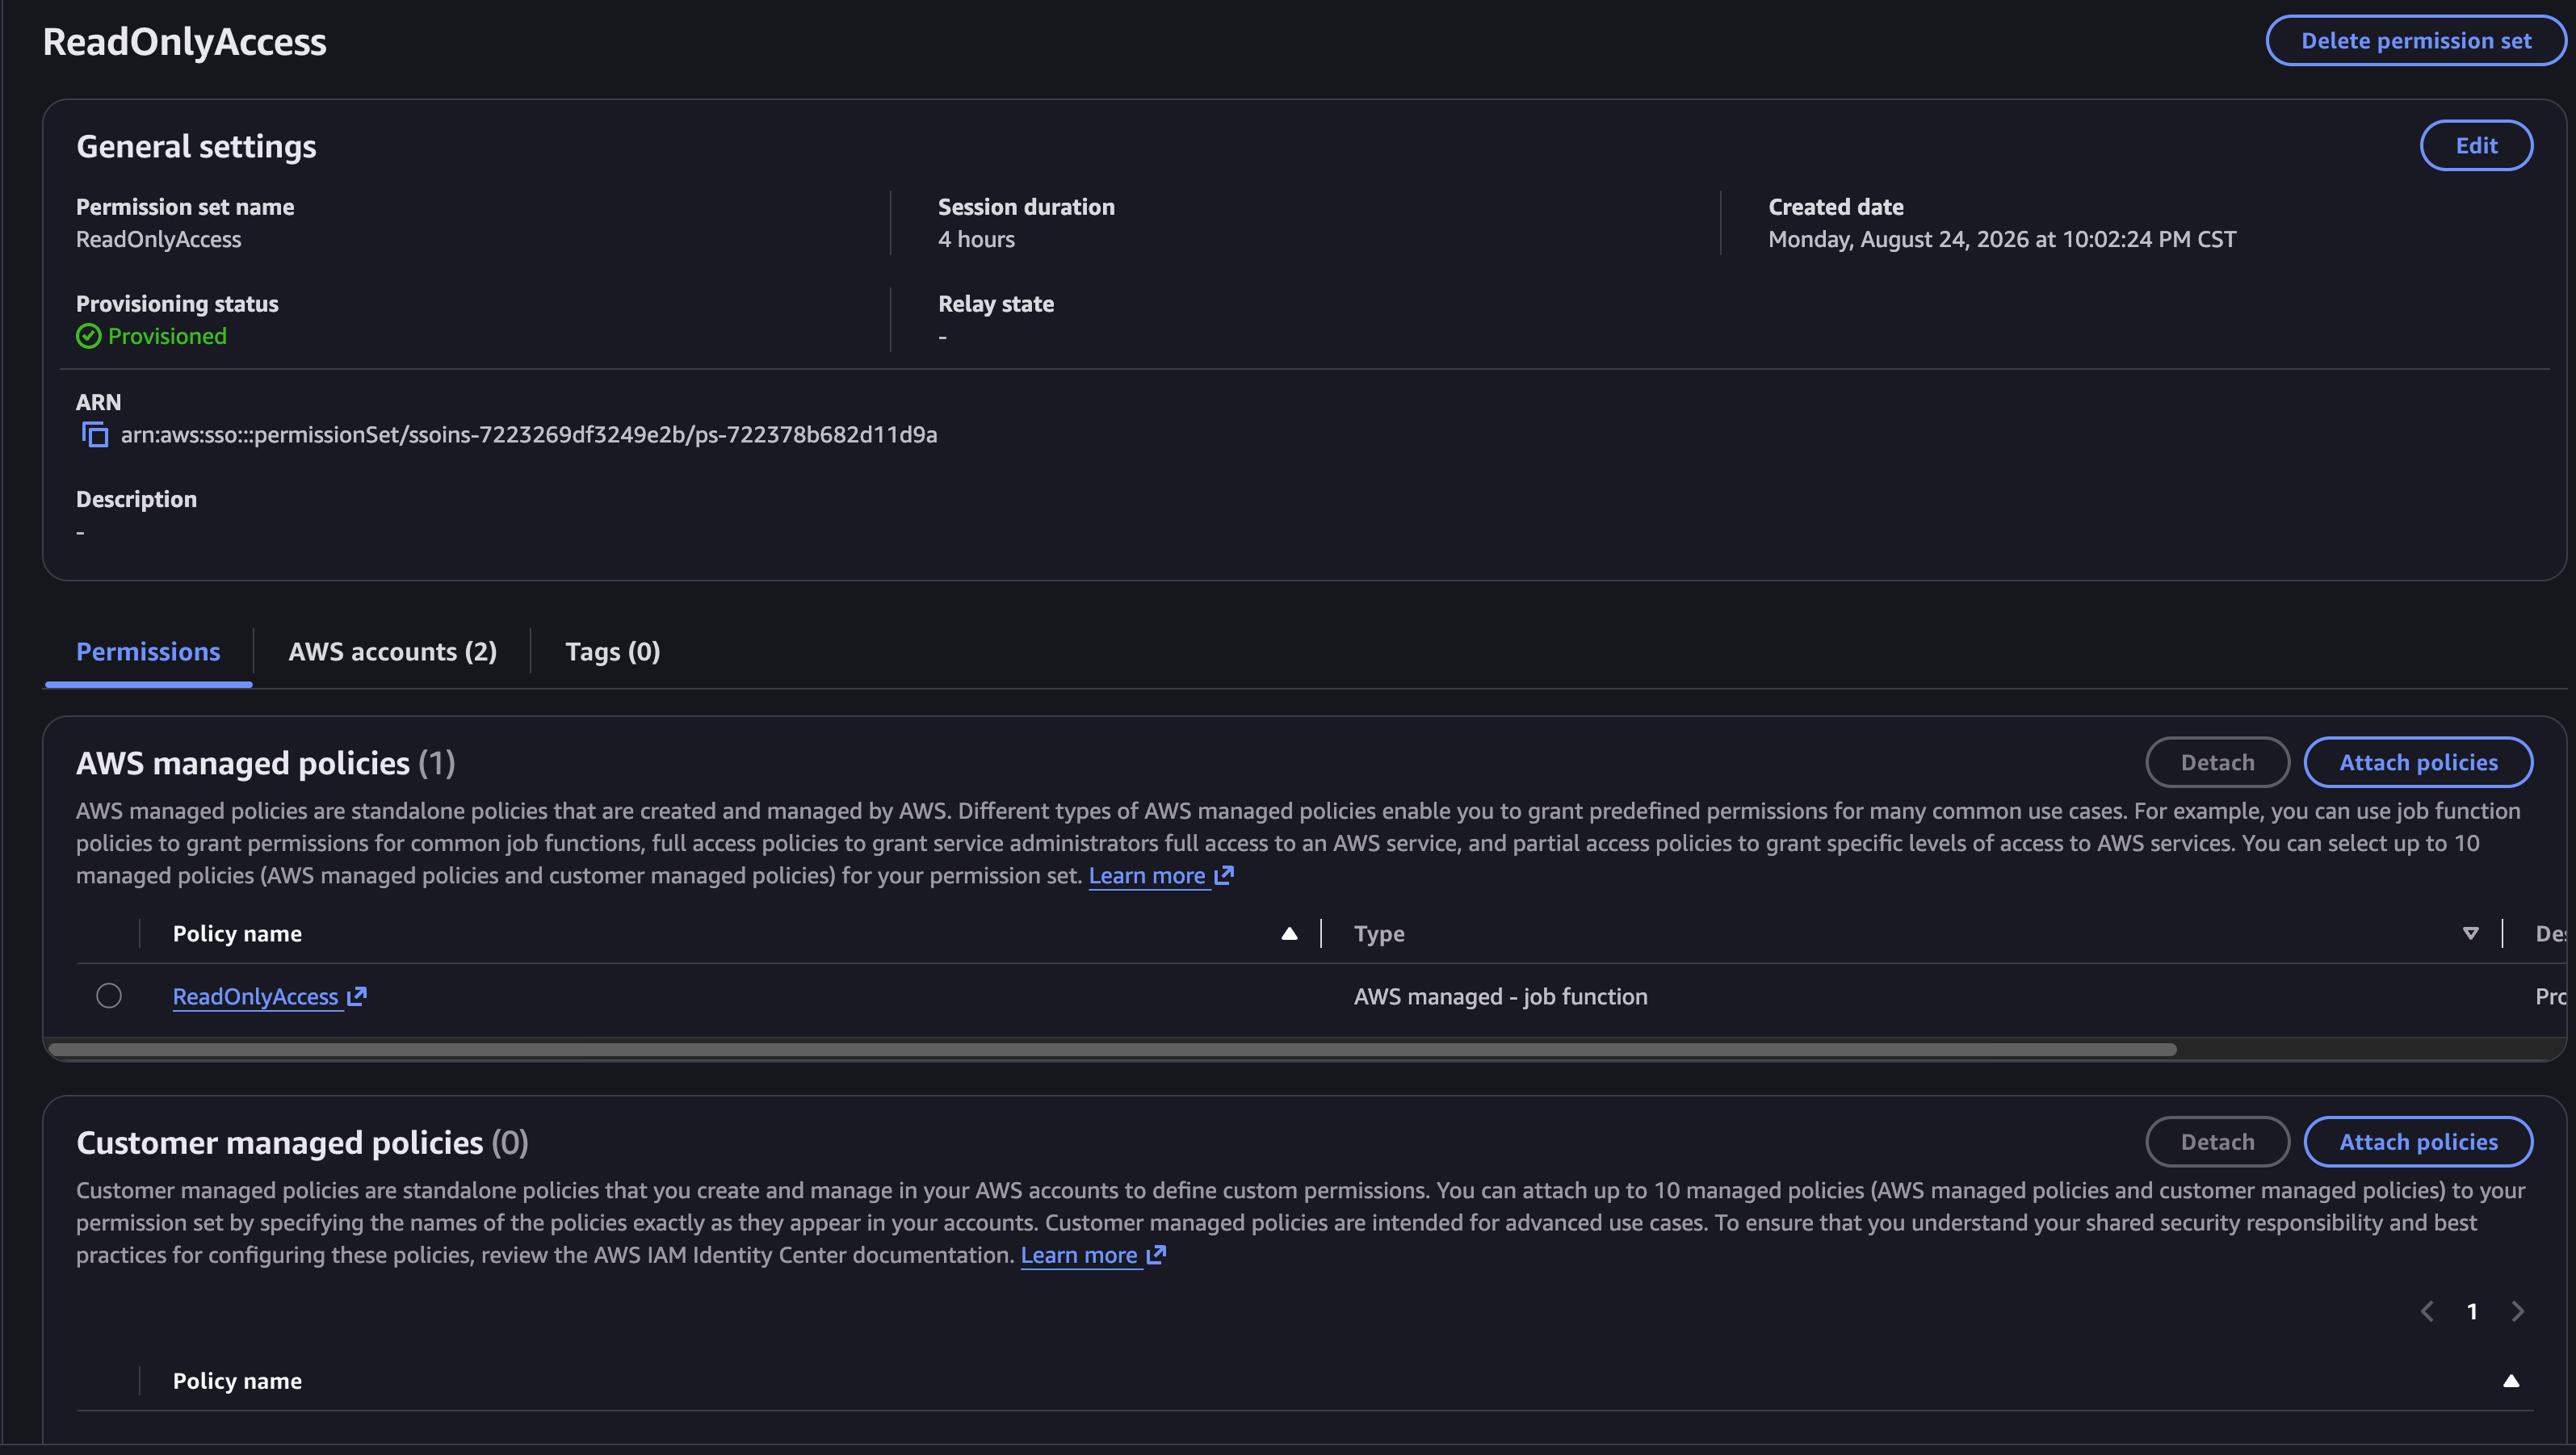
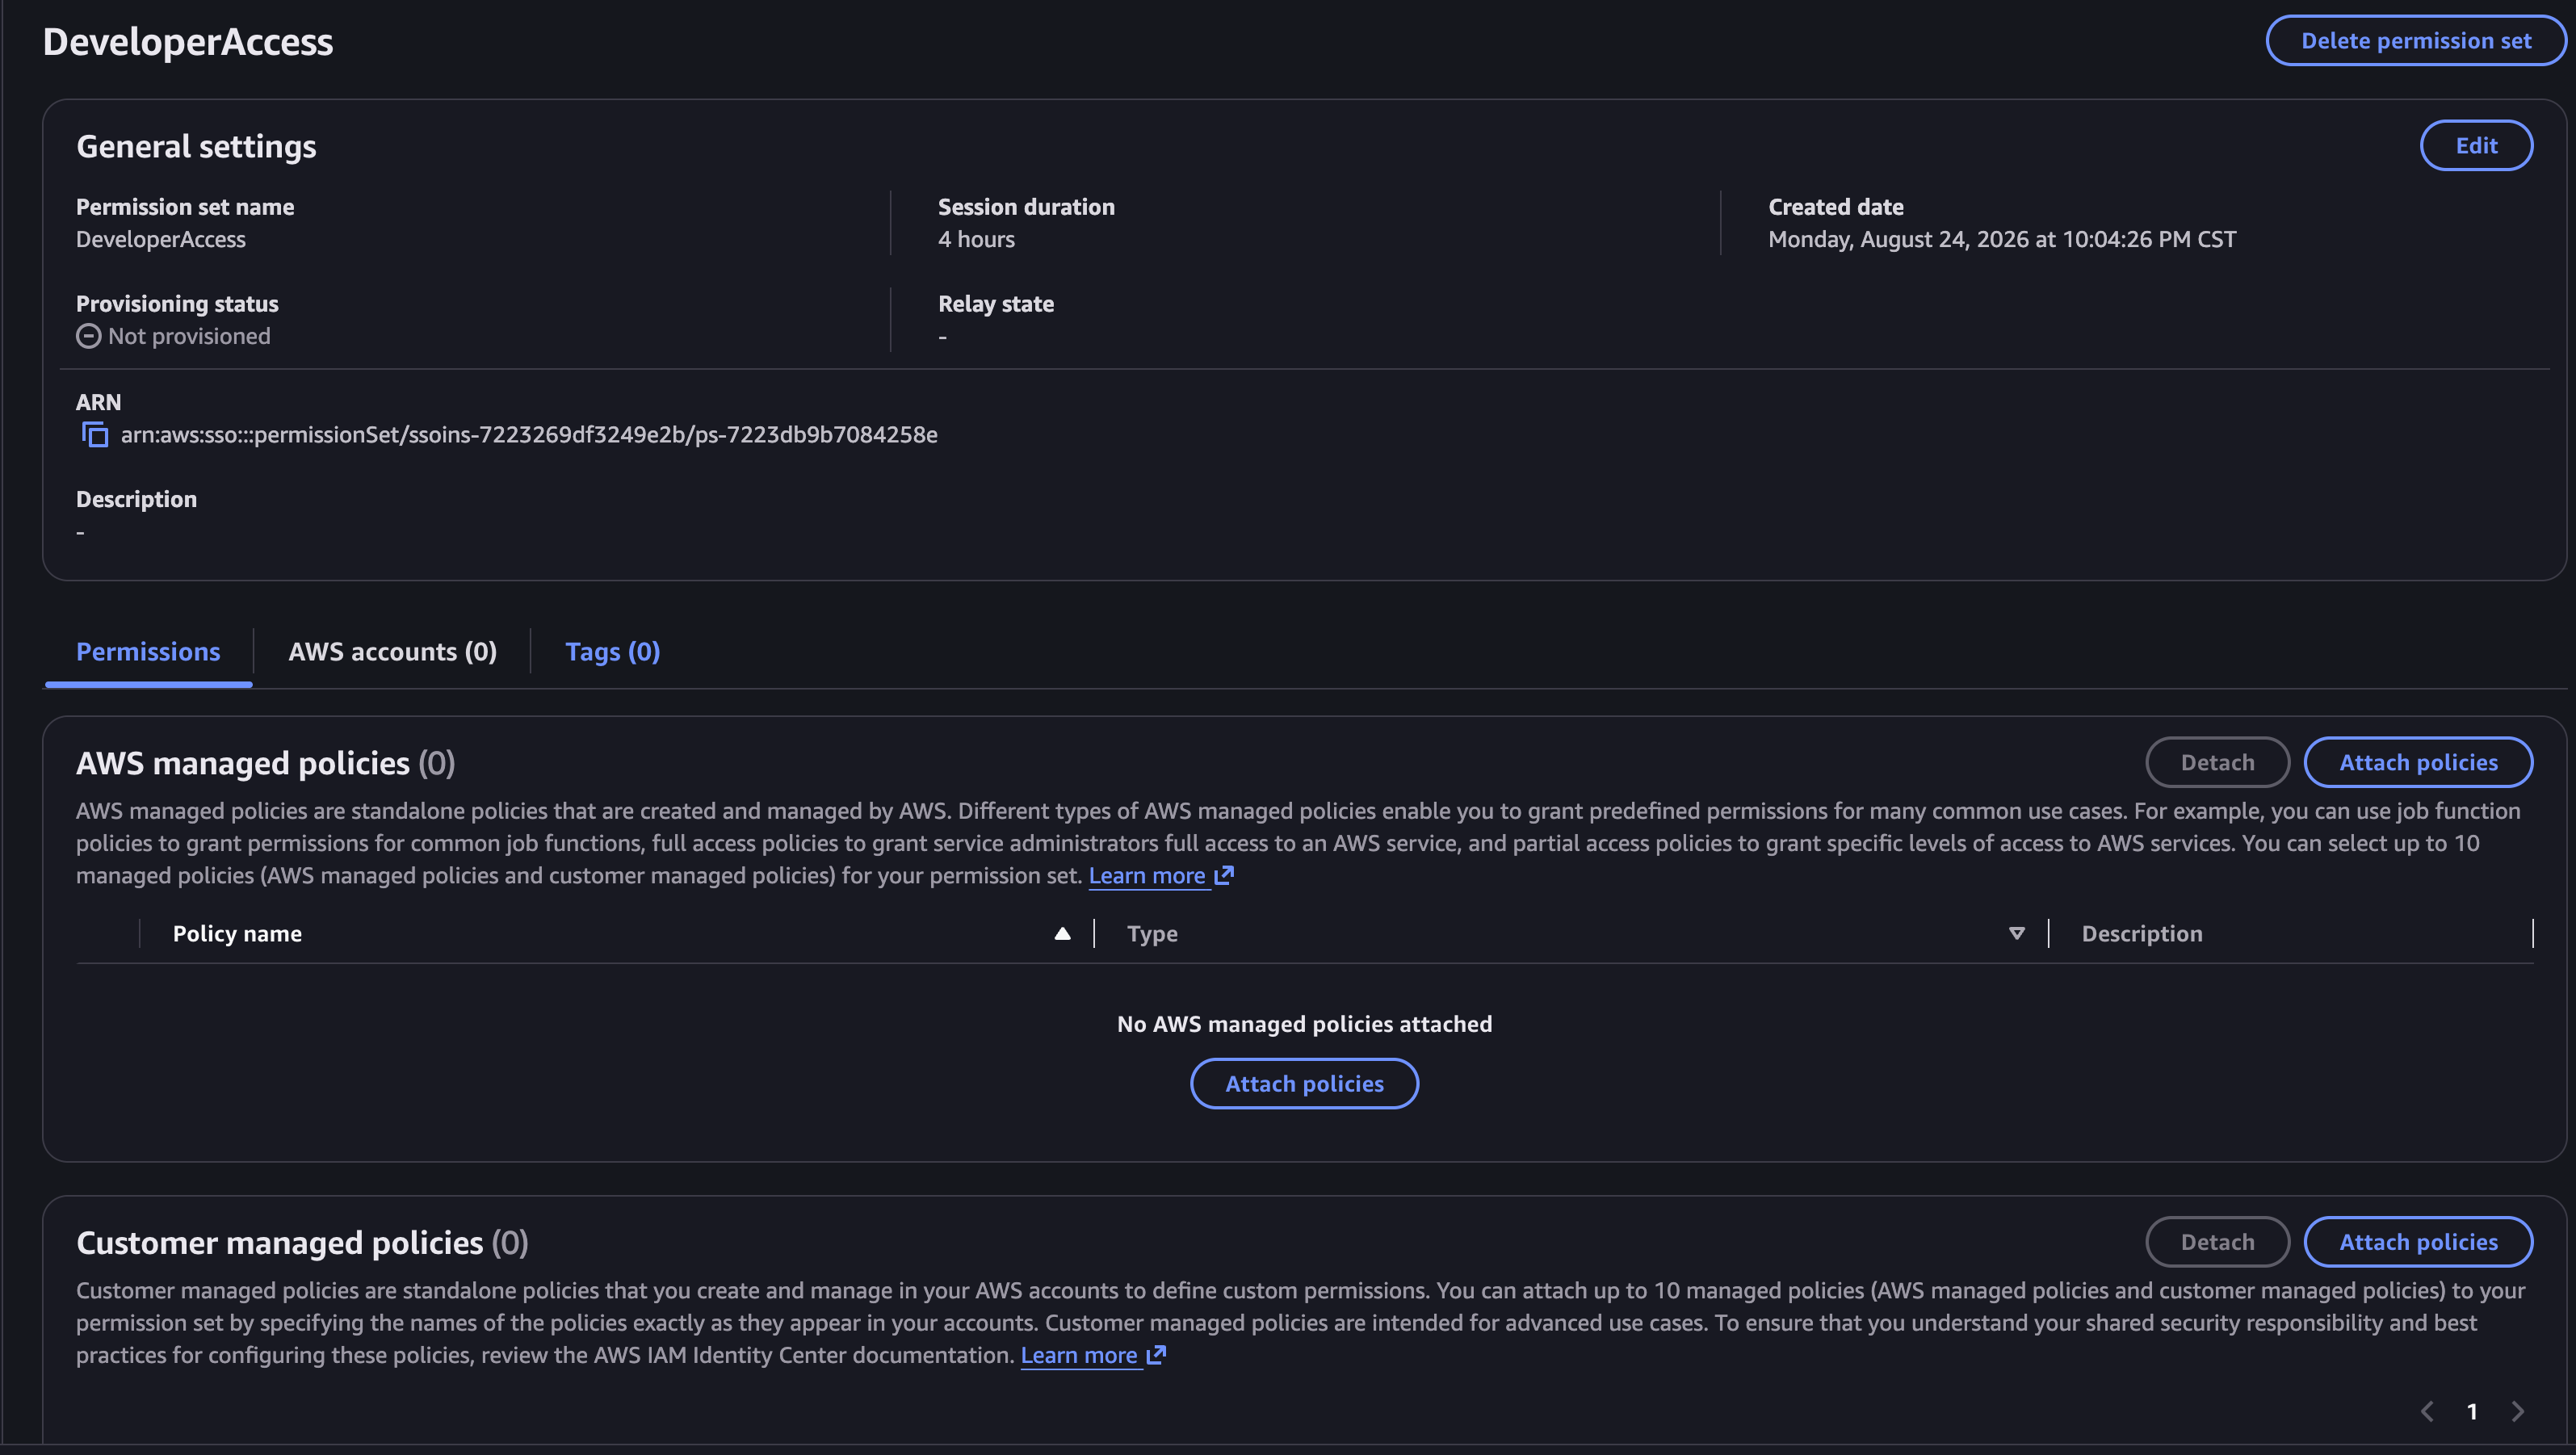
- Permission sets:
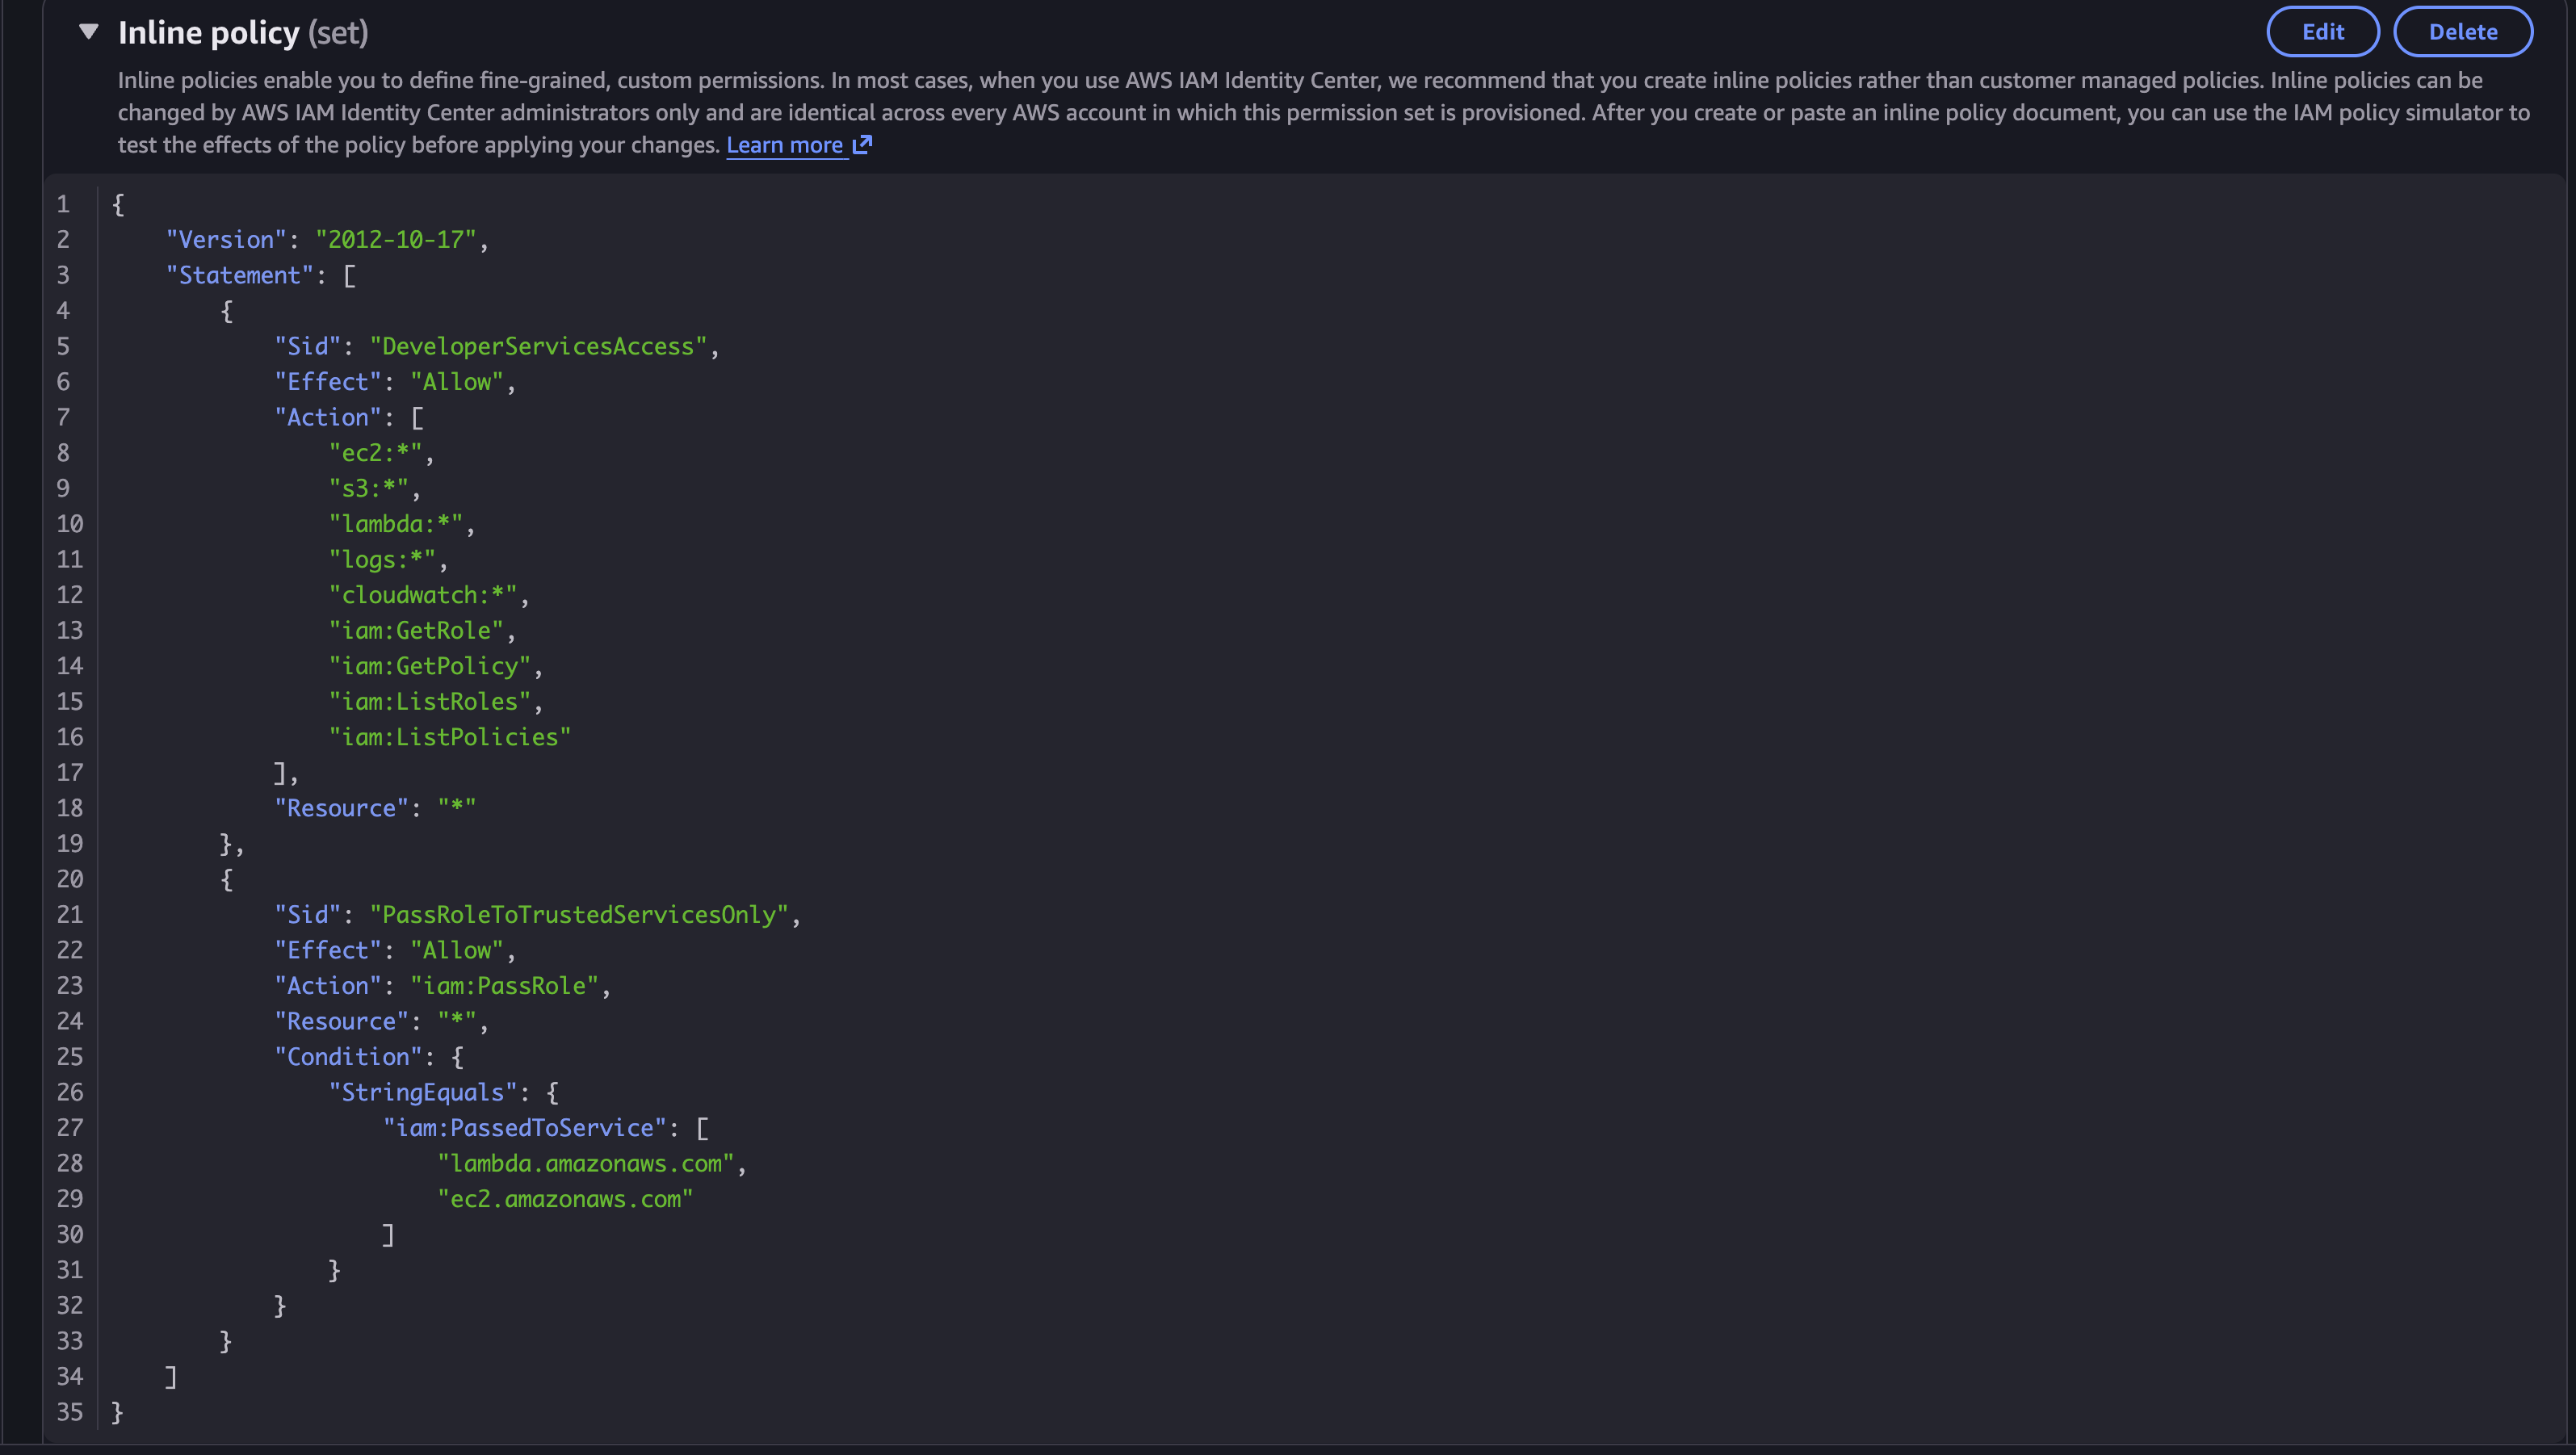
AdministratorAccess(AWS managed, sesión 1 h),ReadOnlyAccess(AWS managed, 4 h),DeveloperAccess(custom, inline policy).
- Detalle interesante para el post:
iam:PassRolerestringido coniam:PassedToServicea Lambda y EC2 (evita escalamiento de privilegios y satisface la advertencia de IAM sobre PassRole con comodín).
| |
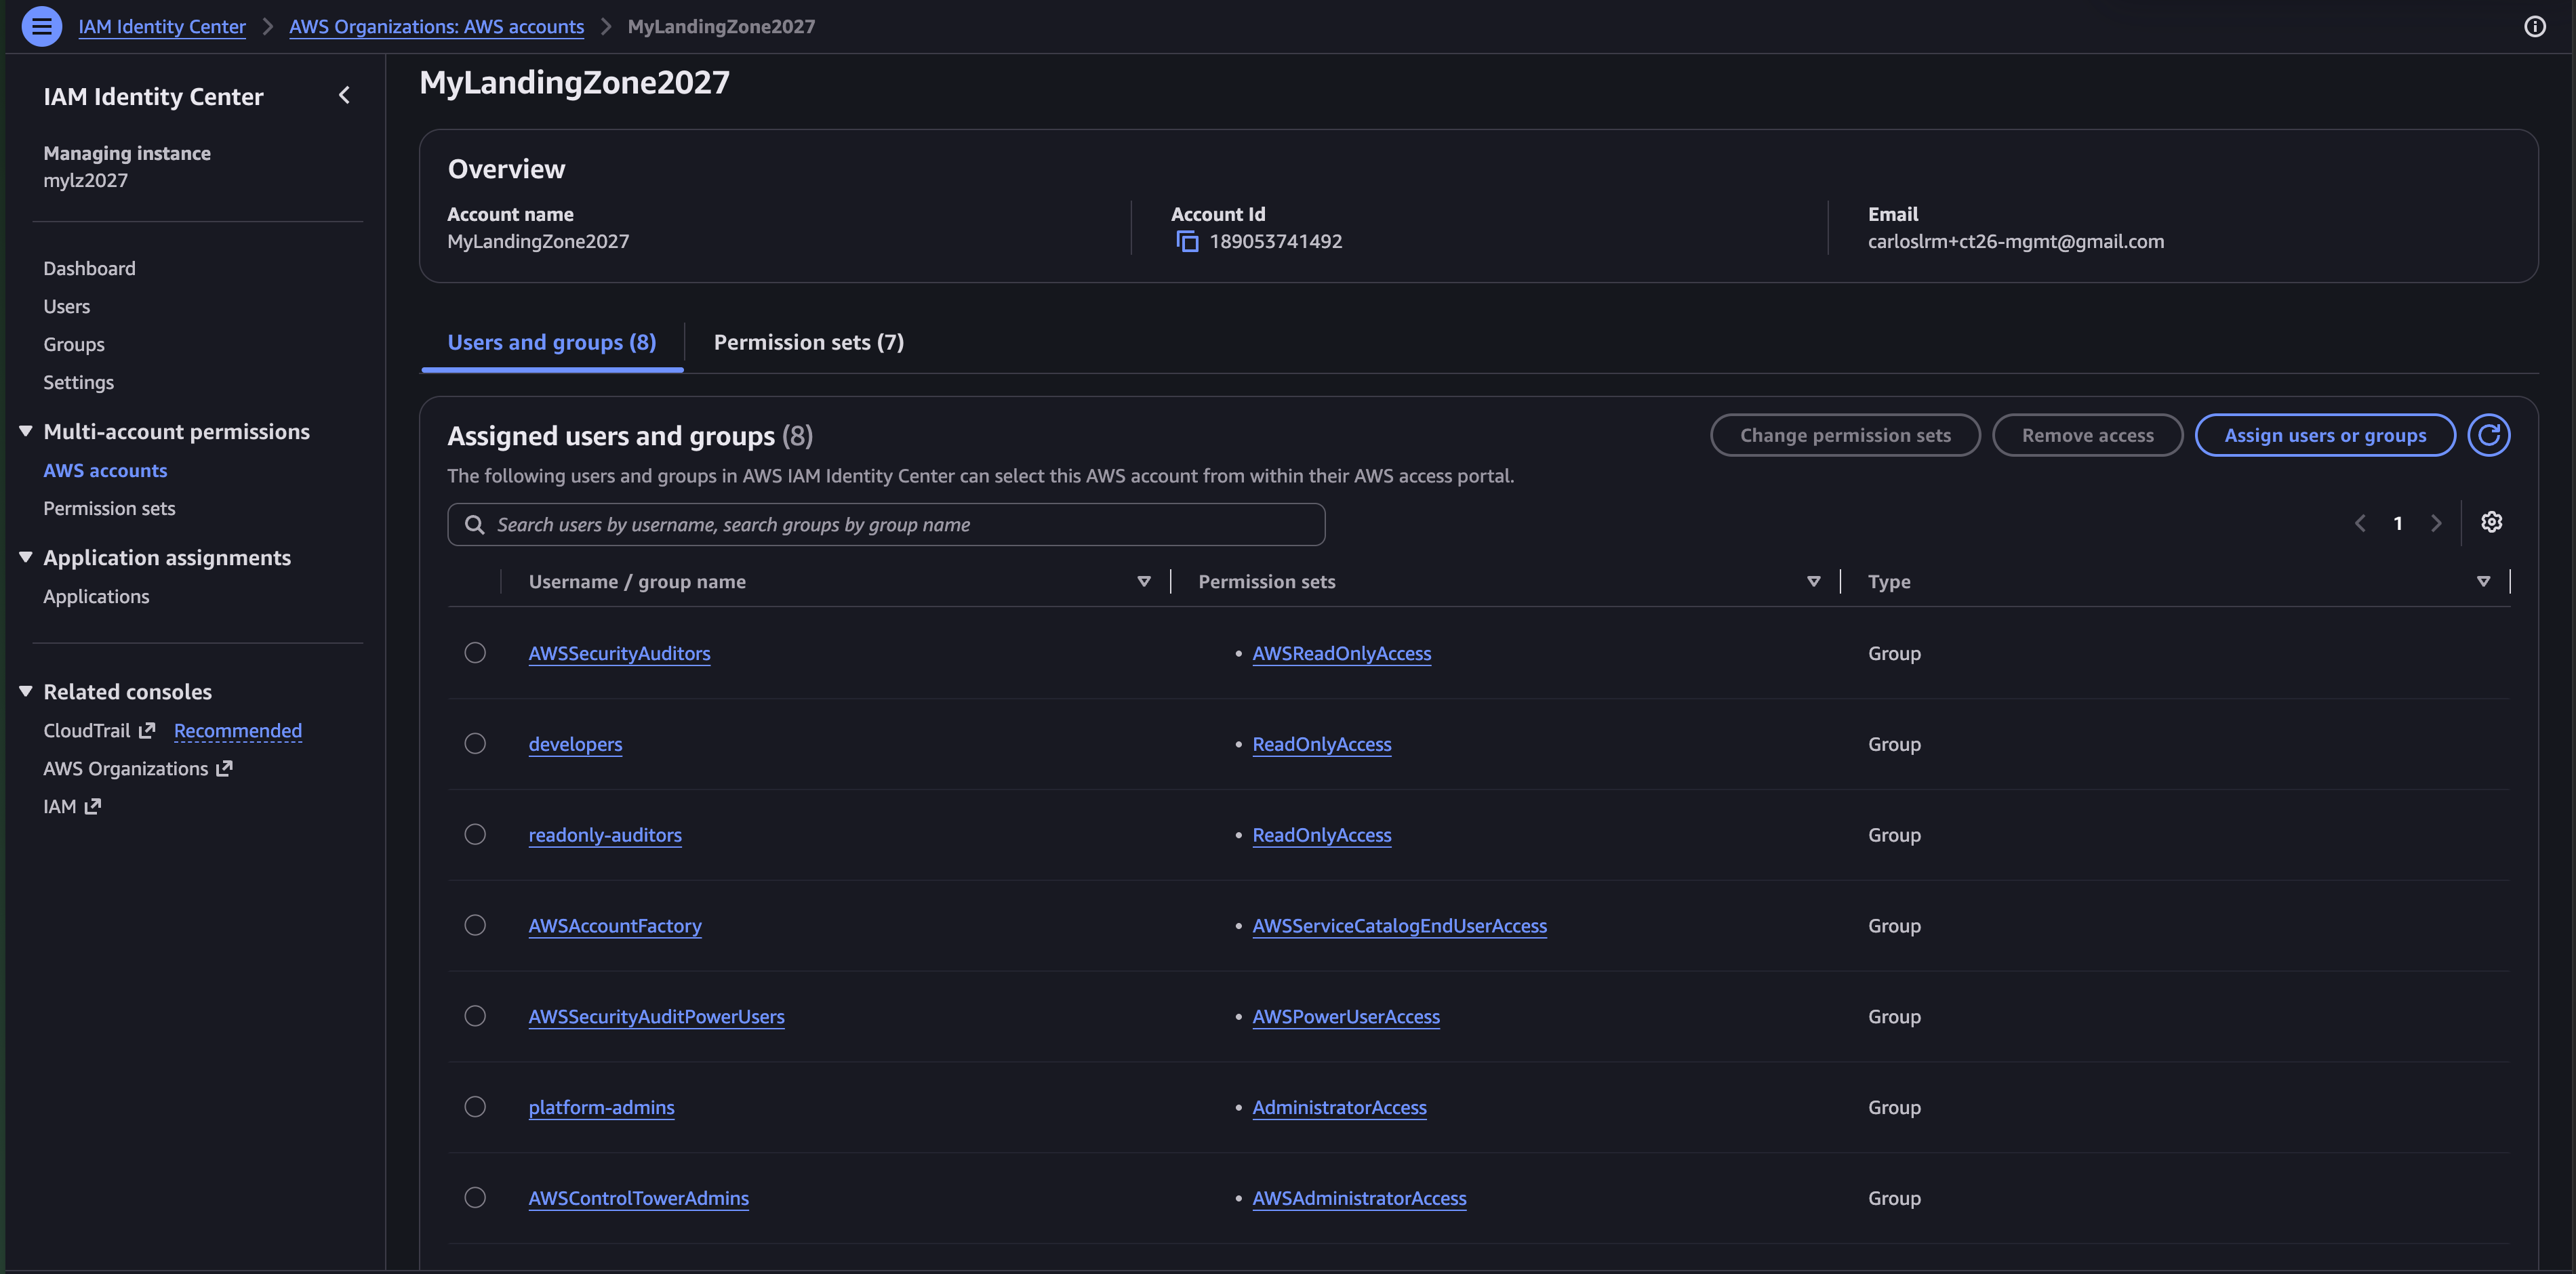
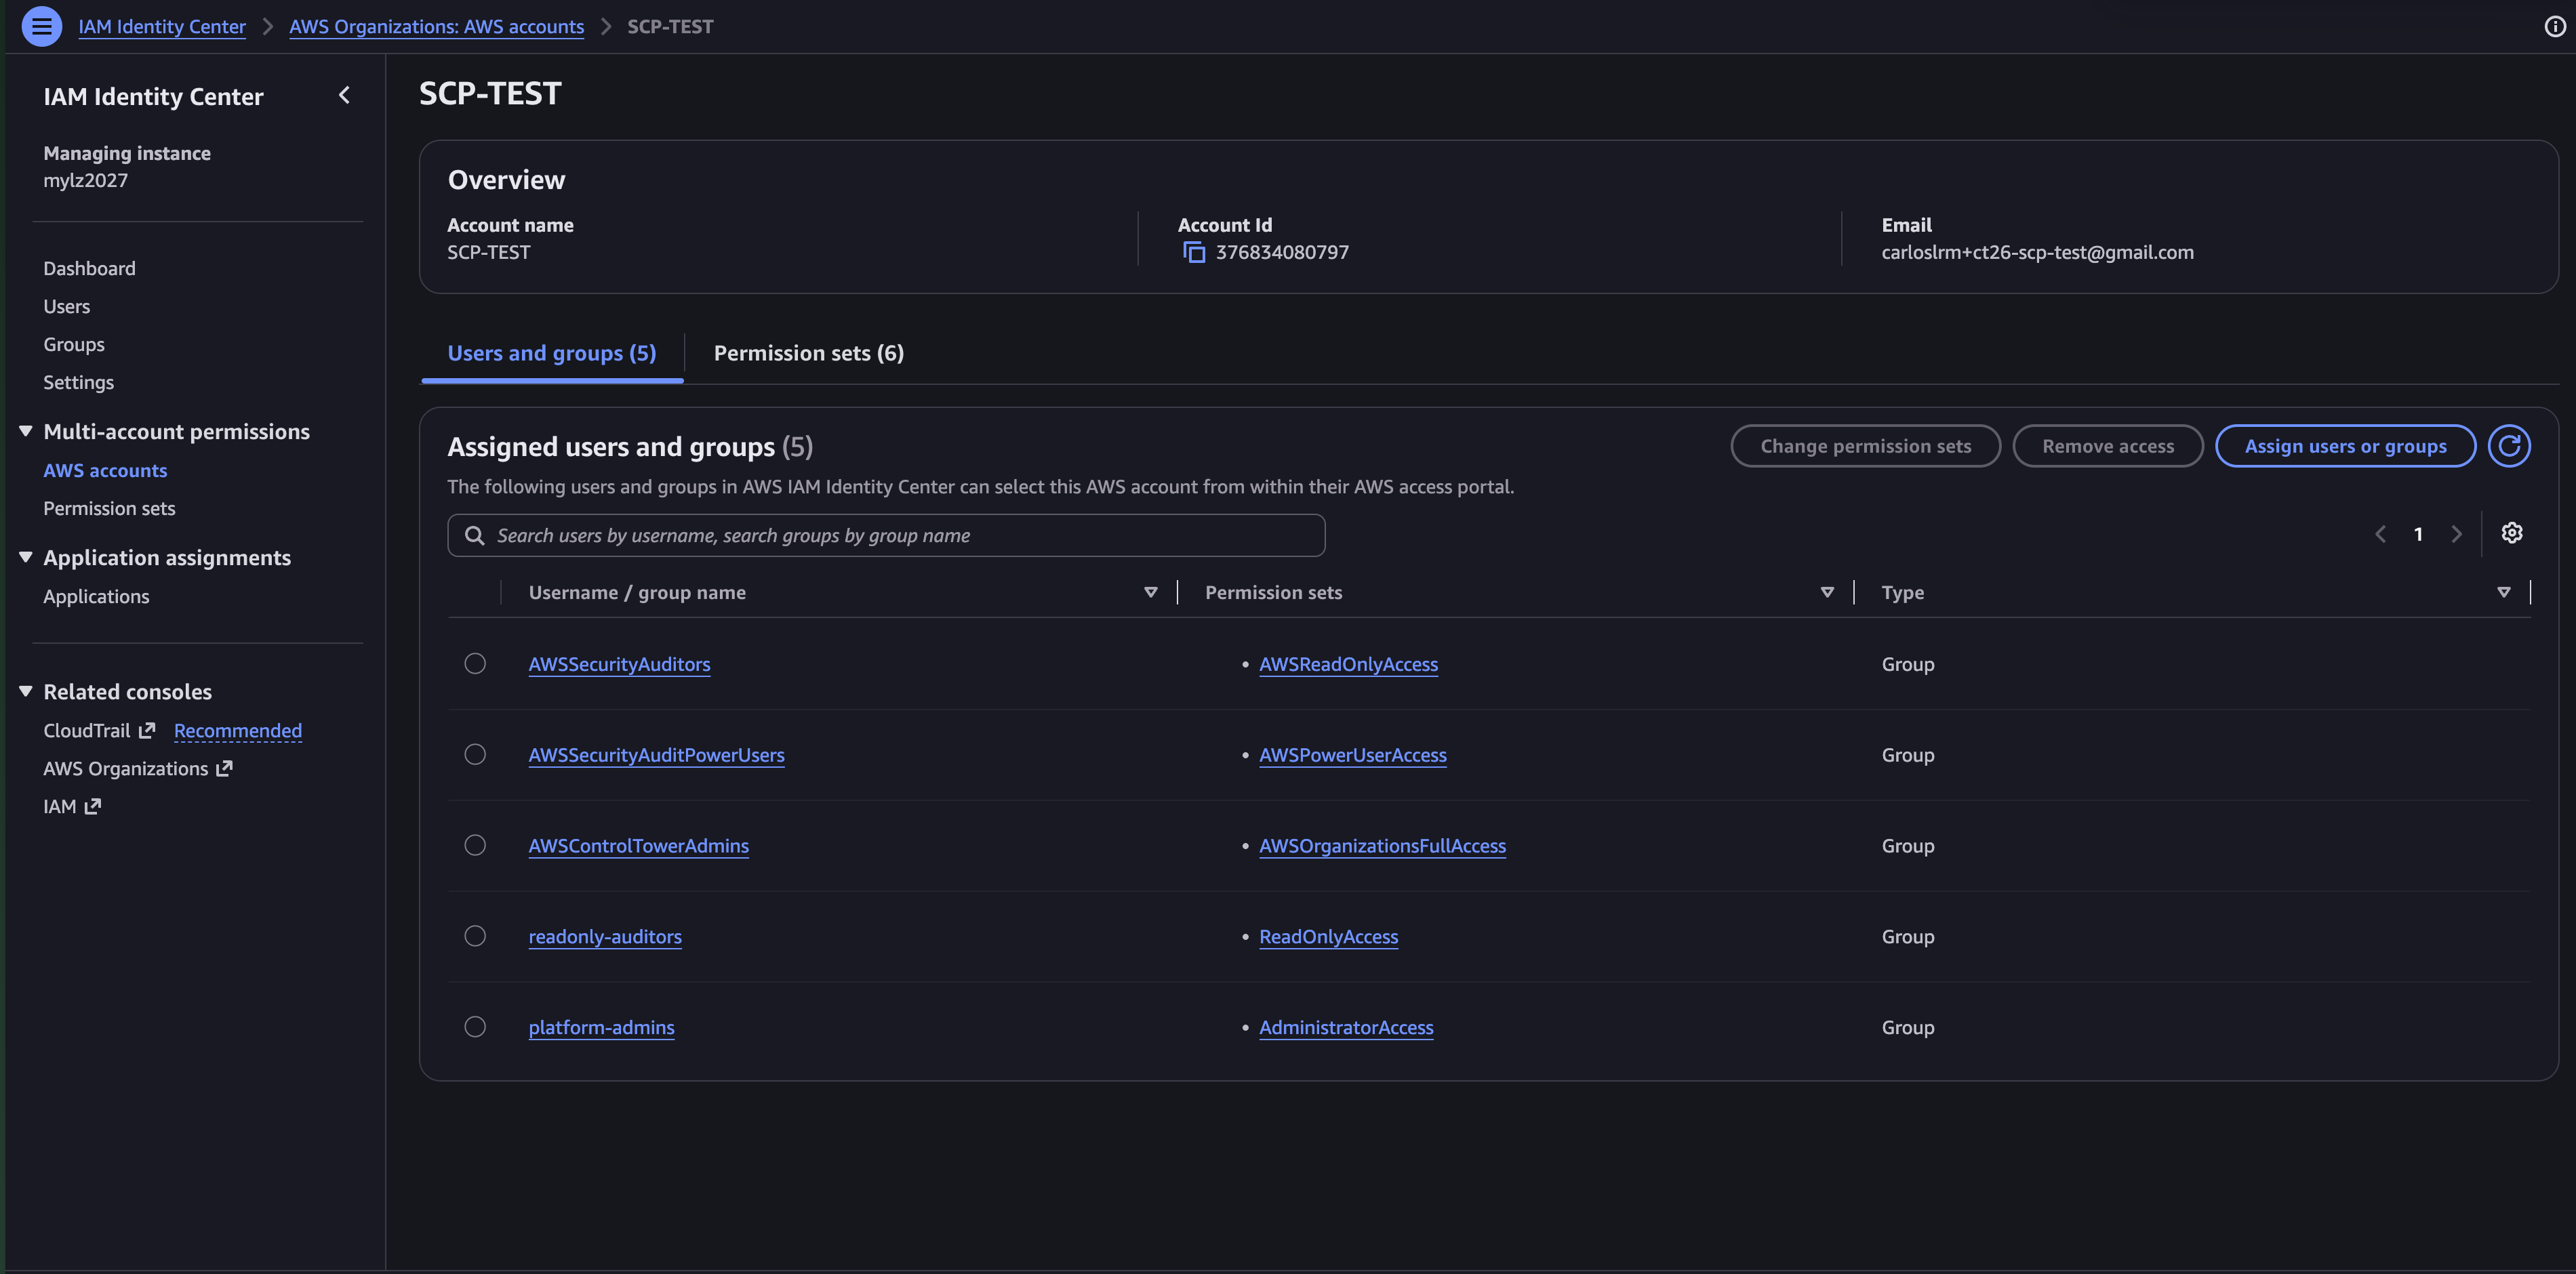
- Asignaciones grupo → cuenta → permission set (management: admins = Admin, auditors y developers = ReadOnly; SCP-test: admins y auditors).
- Usuarios:
carlos.ramirez(platform-admins + developers) ycarlosvsccnp(solo developers, para simular el punto de vista de un developer). Se borró el usuario que creó el wizard por defecto y se personalizó la URL del portal. - Lo que ve cada usuario al entrar al portal:
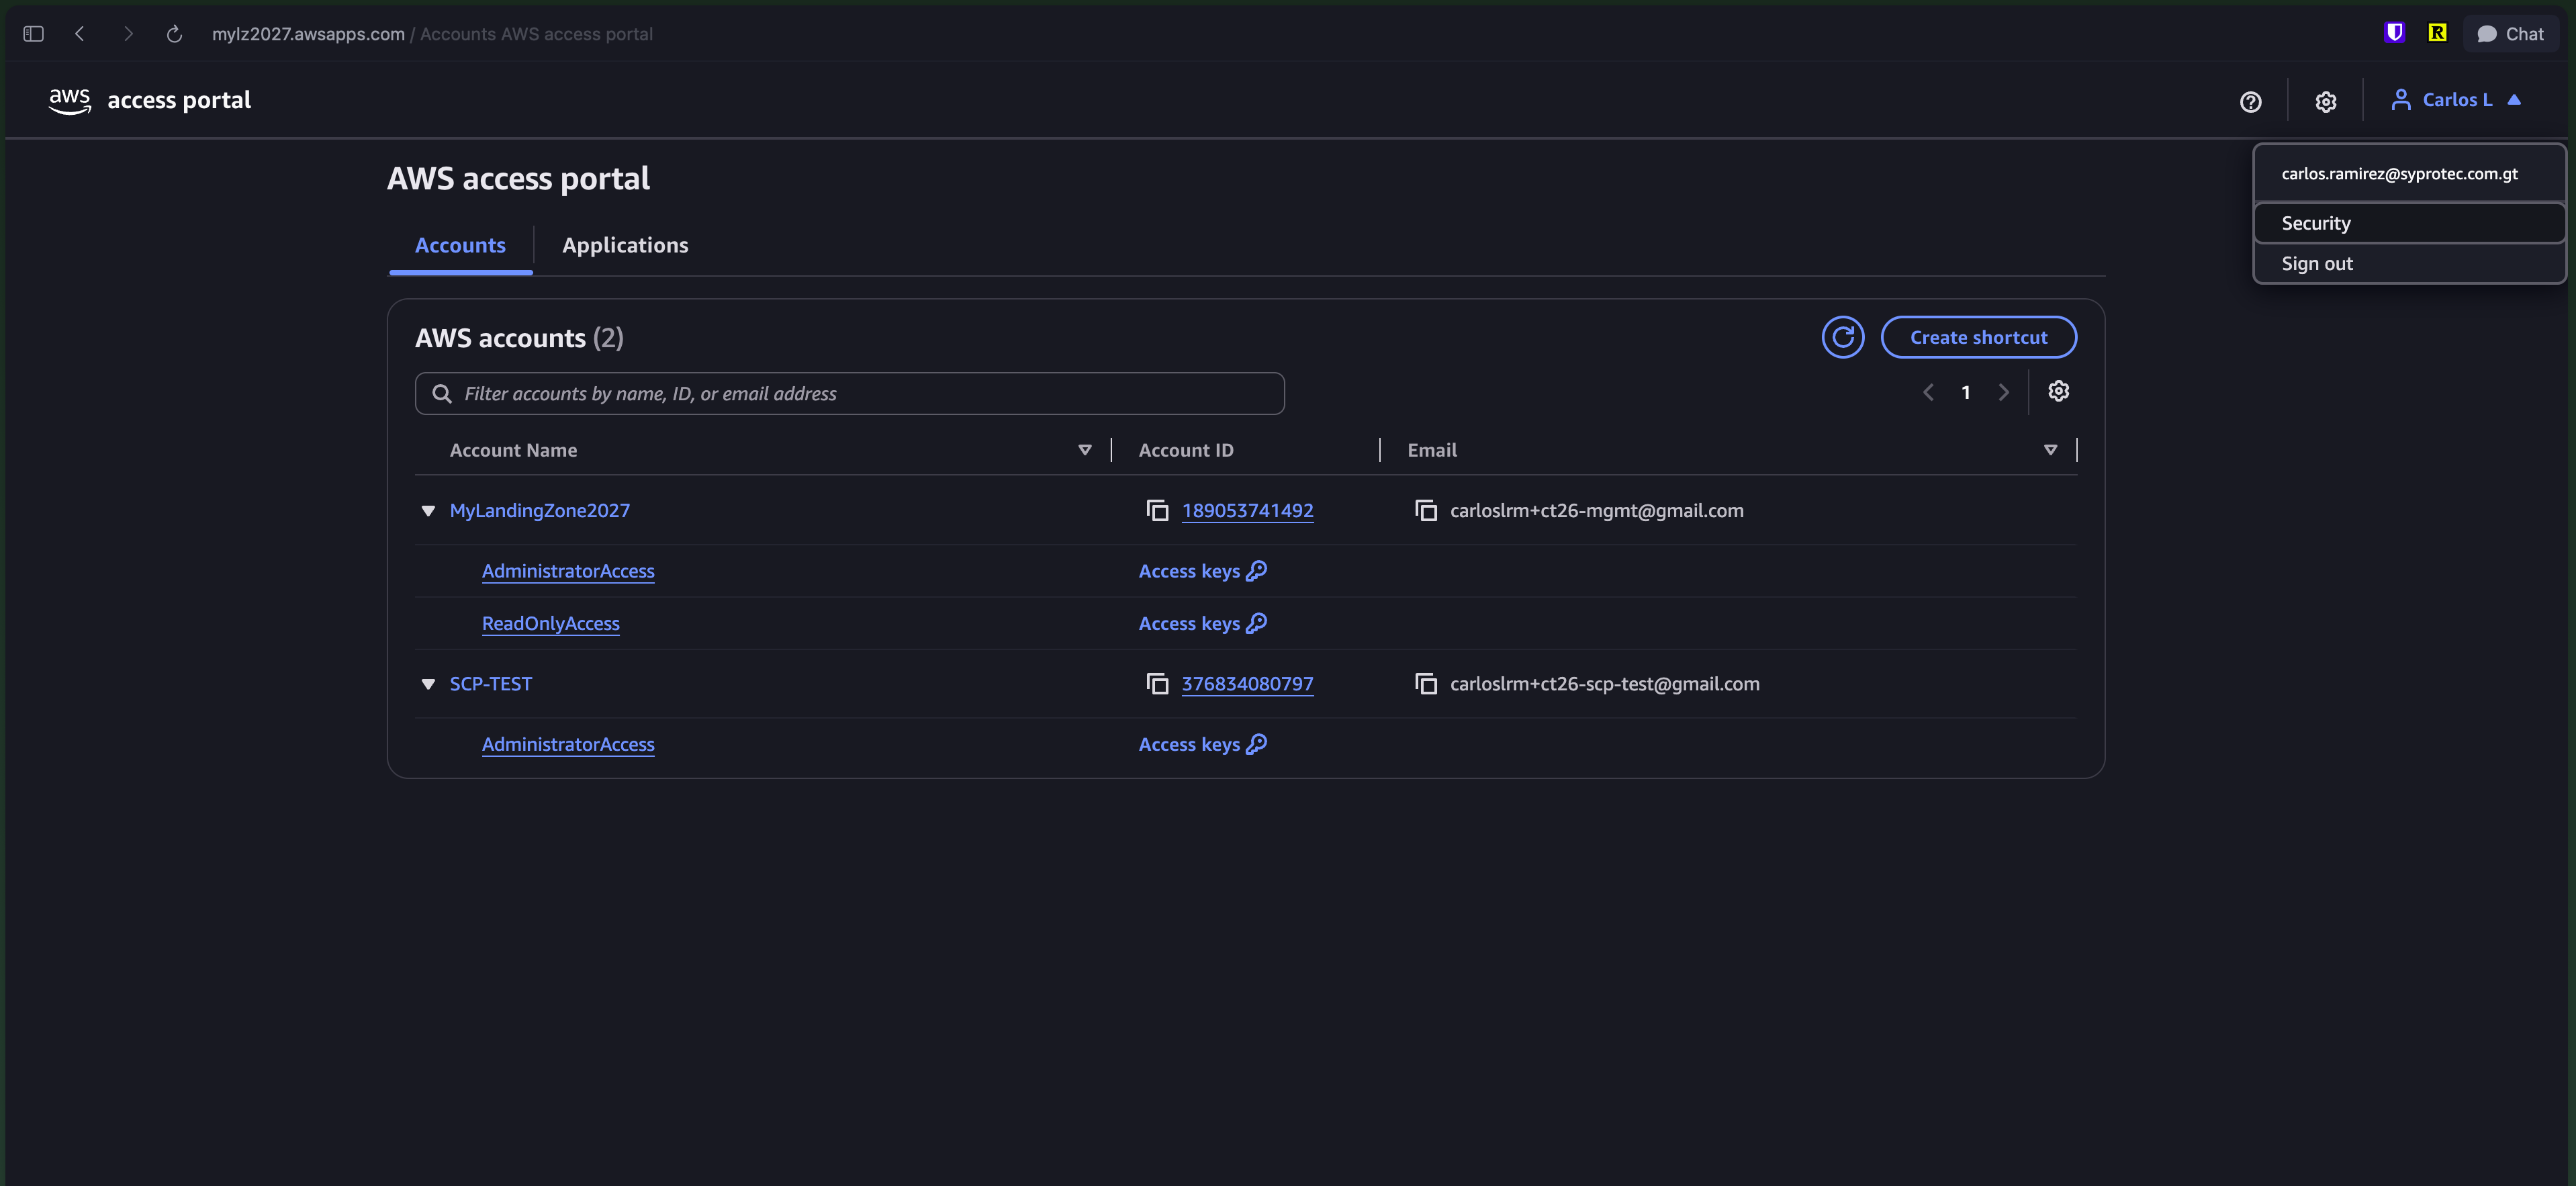
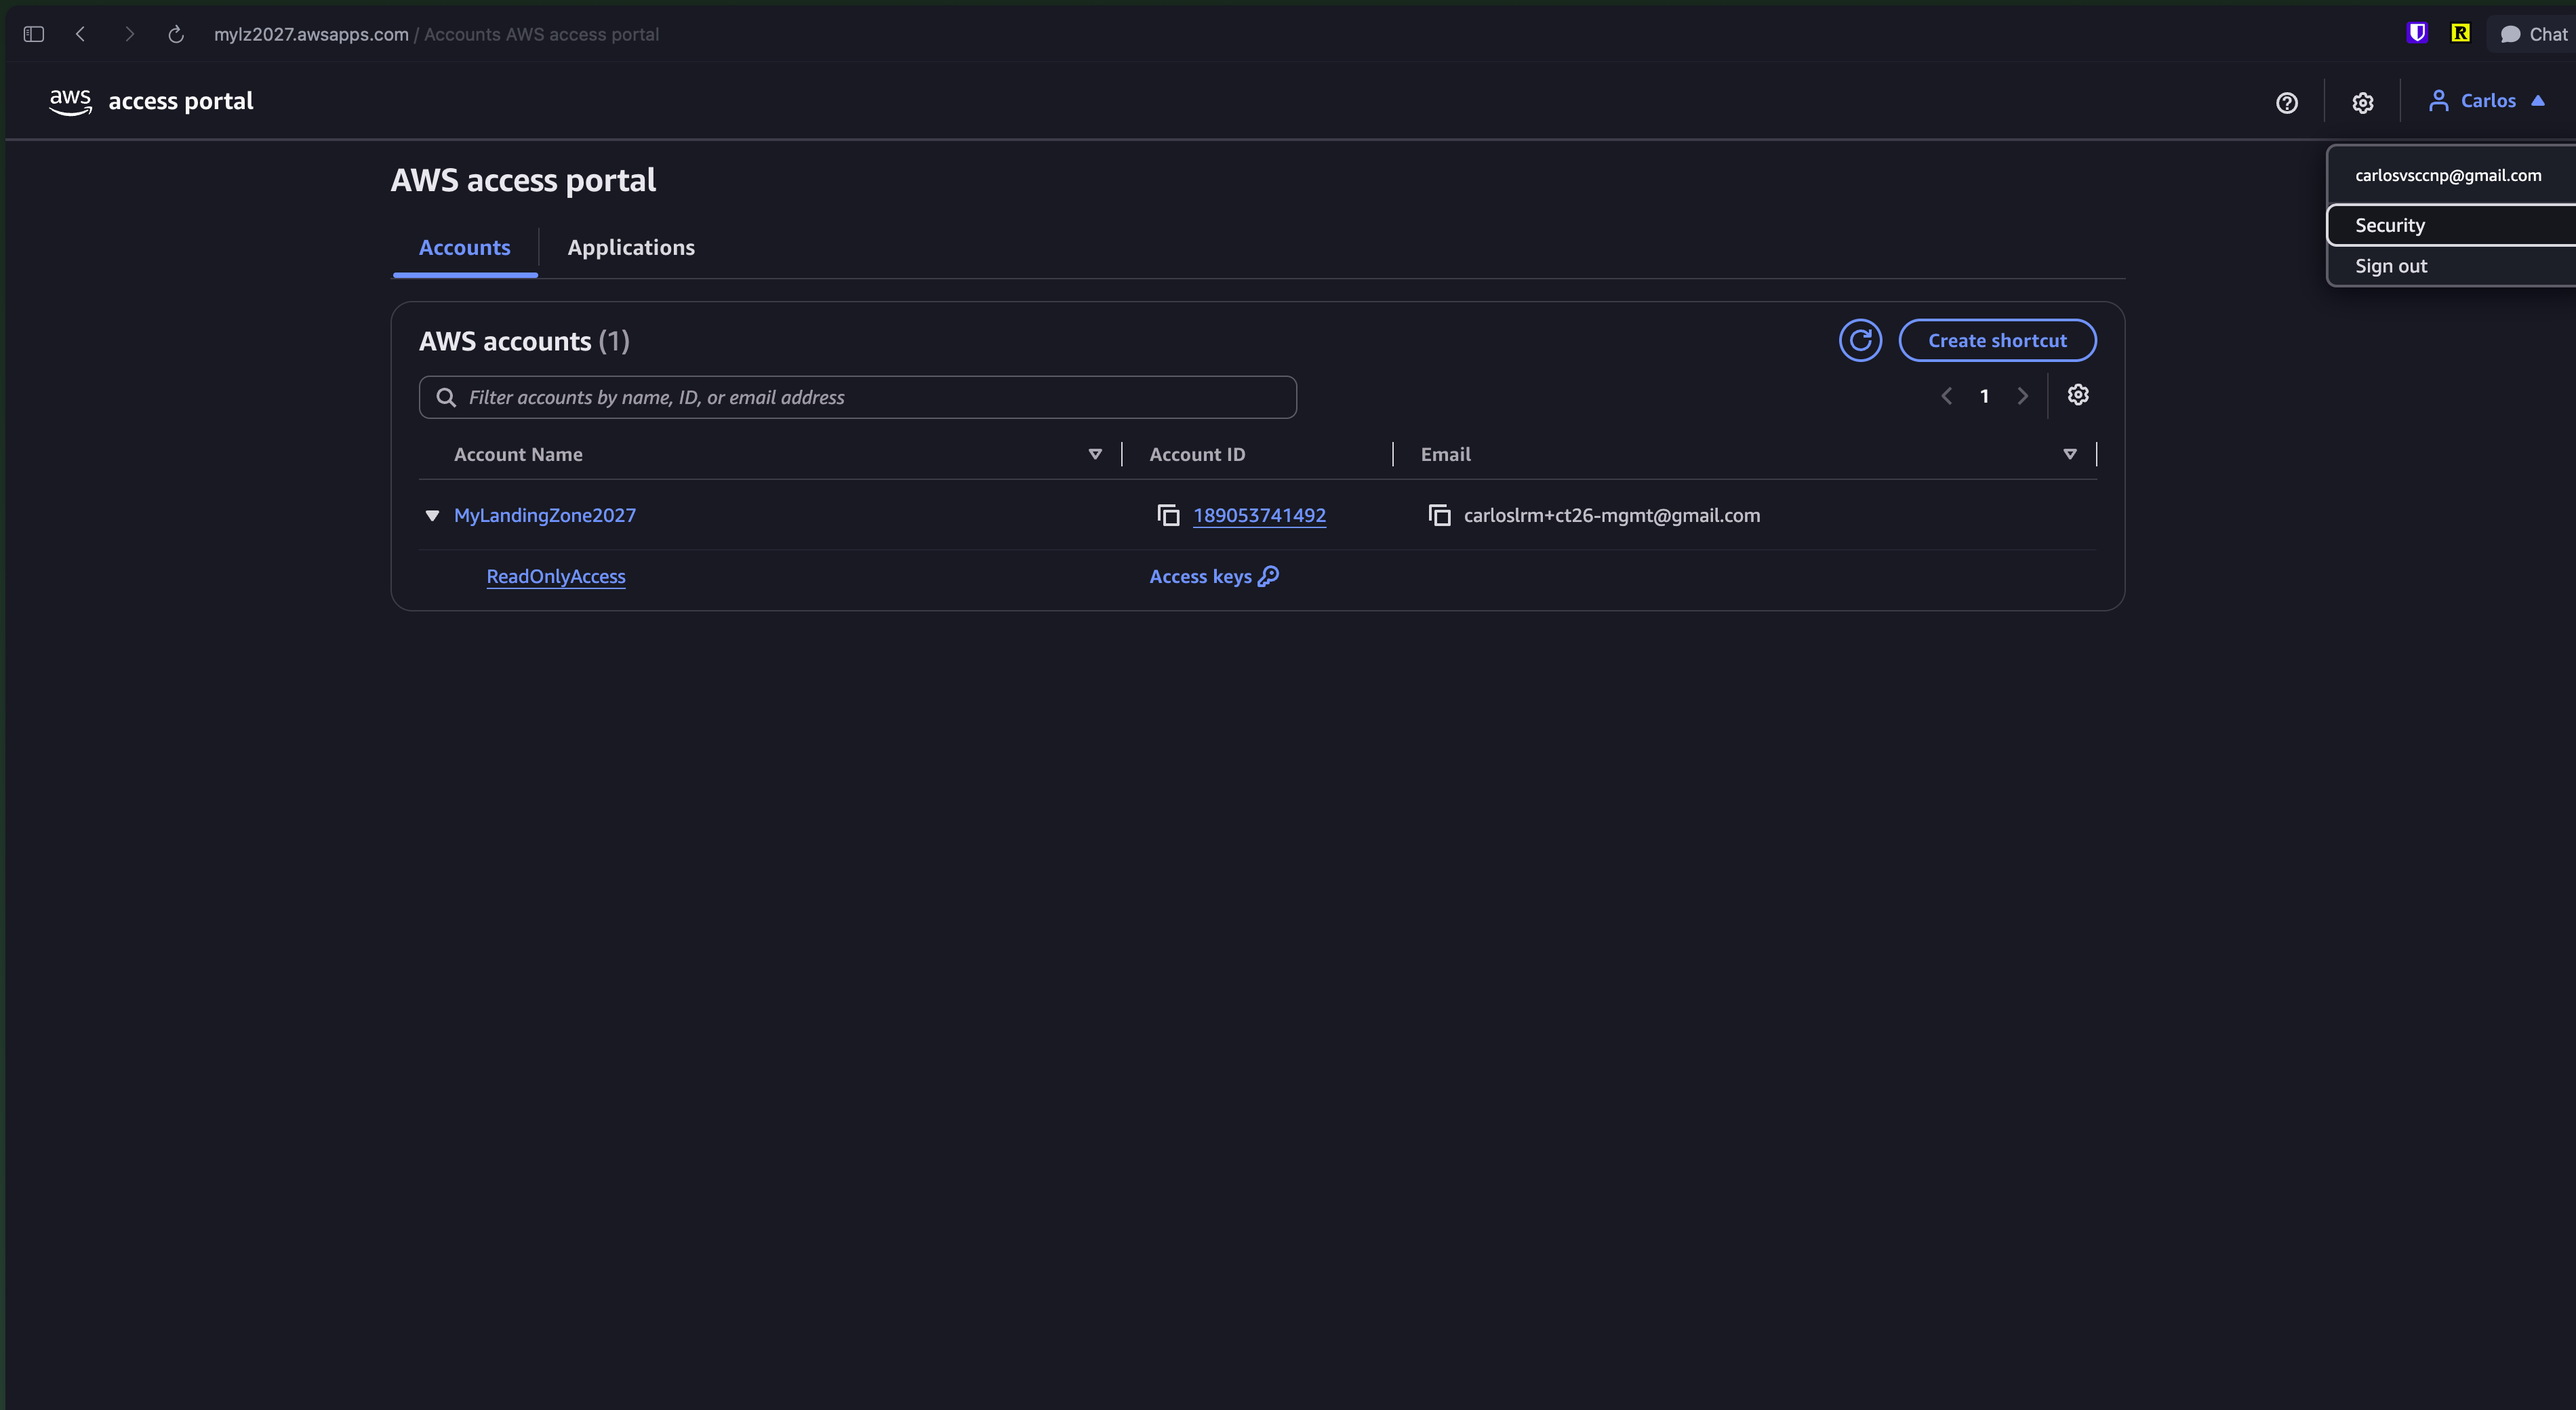
- Flujo de login (tenías este diagrama):
| |
- Punto fuerte: nunca hay credenciales de larga duración en el flujo normal.
- Break-glass (sección que tenías como Placeholder): usuario IAM
breakglasscon consola + MFA y una única política inline que solo permitests:AssumeRolesobreBreakGlassAdminRole; el rol tiene AdministratorAccess y su trust policy exigeaws:MultiFactorAuthPresent: truey está limitado a ese usuario. No quedan otros usuarios IAM en la management.
| |
5.5 SCPs probadas a mano en la “cuarentena” (Policy Staging)
- Metodología: adjuntar la SCP a Policy Staging → probar en
SCP-test(caso negativo + positivo) → desadjuntar. Las políticas se conservan para reutilizarlas en Terraform. - Truco de costo:
ec2:RunInstances --dry-runevalúa permisos (incluidas SCPs) sin crear nada.rds:CreateDBInstanceno tiene dry-run → probarlo significaría crear una instancia real. - Primera prueba de SCP #2 con una copia de prueba (
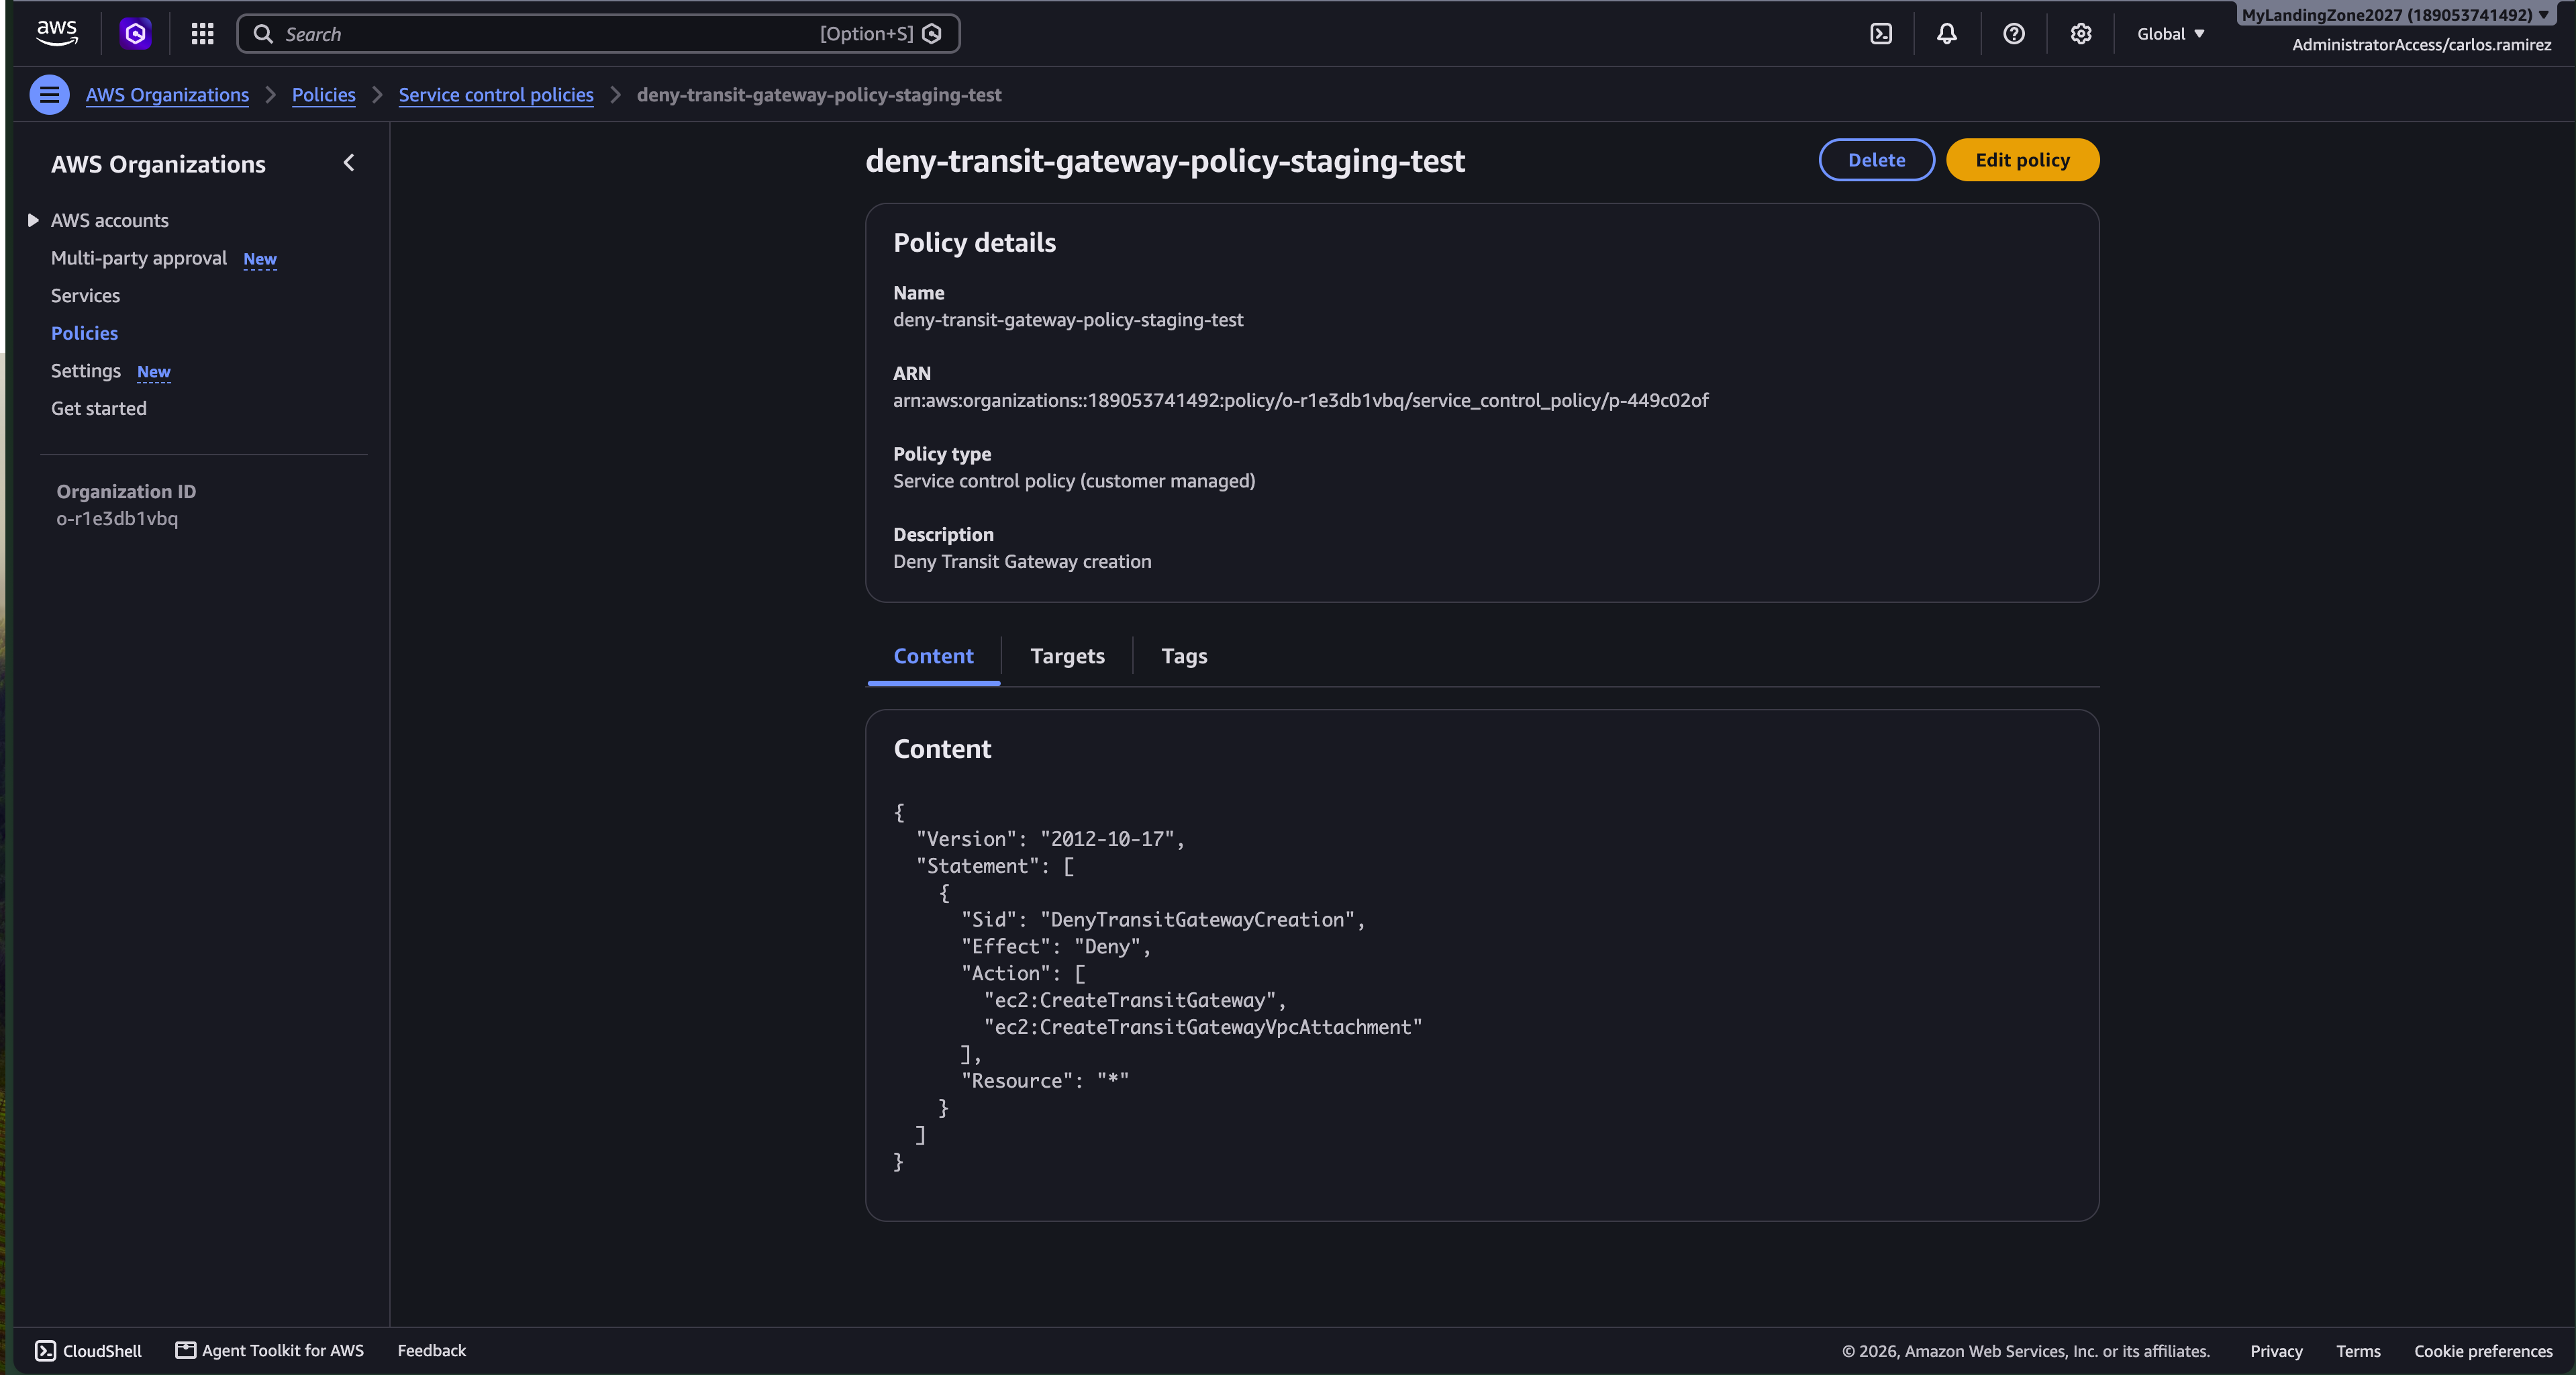
deny-transit-gateway-policy-staging-test):
- Grabaciones de pantalla de esa sesión (útiles si quieres hacer un GIF):
- Creación de la SCP #2:
- Prueba negativa (falla al crear un TGW):
- Desadjuntar la SCP #2 (sin borrarla):
- Creación de la SCP #2:
- SCP #3 con S3: bucket sin tags →
AccessDeniedpor SCP; bucket con tags → creado (y luego borrado a mano — S3 no tiene dry-run). - Los outputs “limpios” de las pruebas están en la sección 8 (ronda de verificación final).
6. Ejecución, fase 2 — pasando todo a Terraform
Todo: ✍️ Escribe aquí — “Aquí sí viene la parte interesante: aplicar Terraform sobre todo lo que hasta ahora había construido a mano.” (frase tuya del borrador)
6.1 Bootstrap del backend (el problema del huevo y la gallina)
(texto tuyo, del borrador)
Este bucket, lógicamente, también se crea con Terraform — lo que plantea un problema de huevo y gallina: no puedo guardar el state de “quién creó el bucket de state” dentro de ese mismo bucket. La solución es un mini-Terraform aparte, aislado, cuyo único propósito es crear esta infraestructura de soporte. Su propio state se guarda en local (un único archivo) y, una vez creado el bucket, casi nunca se vuelve a tocar.
Material en bruto:
terraform/bootstrap/: bucket S3 con versionado, bloqueo de acceso público, cifrado SSE-S3. Provider AWS~> 5.0(v5.100.0).- Resultado:
Plan: 4 to add→Apply complete! Resources: 4 added. Primer recurso real del proyecto creado con Terraform (2026-09-02). - Luego el
main.tf“real” enterraform/con el bloquebackend "s3"(bucket,key, profile,use_lockfile = true→ sin DynamoDB).
6.2 Adoptar lo que ya existía sin romperlo (terraform import)
- Escribiste en
.tflas 7 OUs no gestionadas por CT y las 3 SCPs describiendo exactamente lo que ya existía, sin recrear nada. Los JSON de las políticas se leen confile(...), no se duplican en el.tf. - Al listar SCPs aparecen
aws-guardrails-*: son los controles internos de Control Tower → fuera de Terraform; solo se importan las 3 propias. - A propósito no declaraste attachments todavía: las SCPs estaban “detached” en AWS y el
.tfdebía reflejar exactamente eso. Adjuntarlas es un cambio de comportamiento → paso aparte.
| |
- La anécdota: el primer
terraform planpost-import no dio “No changes” — quería borrar eldescriptionde las 3 políticas porque el.tfno lo declaraba:
| |
- Fix: agregar el
descriptionexacto →No changes. Your infrastructure matches the configuration.
6.3 Activar los guardrails
- Attachments SCP → OU declarados en
terraform/scps.tfy aplicados el 2026-09-03 (SCP #1 extendida a Sandbox el 2026-09-08).terraform planposterior: sin drift. - Después cerraste la cuenta
SCP-test(Organizations → Actions → Close)… y más tarde tuviste que reabrirla (sección 8).
7. Networking — hub-and-spoke y un plan de direccionamiento “enterprise”
Todo: ✍️ Escribe aquí
Material en bruto:
- Dos diseños de VPC distintos, porque
Networkingno es una cuenta de workloads (lo detectaste tú: un solo módulo “VPC estándar” era un error):- Hub
Networking: sin IGW, solo subnets privadas + subnets “Public (Future)” reservadas para un egress centralizado futuro. Su trabajo es concentrar peering (y más adelante una VPN site-to-site), no exponer nada a internet. - Workloads: módulo reutilizable
vpc-baseline— 3 AZ, capas Public / App / Data + un slot reservado por AZ. - Sandbox: módulo propio más pequeño
vpc-sandbox(/23→/26, 2 AZ).
- Hub
- Plan de CIDR jerárquico (revisado el 2026-09-07; sustituyó un plan plano de 5 ×
/20):
| Bloque | Uso |
|---|---|
10.0.0.0/21 | Networking (hub) |
10.0.8.0/21 | Shared Services (reservado) |
10.0.16.0/21–10.0.40.0/21 | 4 × /21 reservados para tooling transversal/seguridad |
10.0.48.0/23–10.0.62.0/23 | Pool Sandbox: 8 × /23 |
10.0.64.0/20–10.0.176.0/20 | Pool Dev: 8 × /20 |
10.0.192.0/20–10.1.48.0/20 | Pool Staging: 8 × /20 |
10.1.64.0/20–10.1.176.0/20 | Pool Prod: 8 × /20 |
- Los pools de 8 slots son margen de direccionamiento, no un compromiso de crear 8 cuentas por entorno.
- Cambiar el CIDR primario de una VPC no se puede en caliente → reconstruir el hub (bajo riesgo: aún sin peerings).
7.1 La cuenta Networking, versión 2: nacer gestionada por Control Tower
- La primera
Networkingla creaste con Terraform (aws_organizations_account) → nunca tuvo baseline de Control Tower (ni CloudTrail/Config de CT ni rolAWSControlTowerExecution). - Decisión (2026-09-07): cerrarla y recrearla con Account Factory. Tropiezos en el camino:
terraform destroyagotó su timeout de 10 min esperando el cierre, aunque el cierre sí ocurrió → limpieza conterraform state rm.- Control Tower se negó a registrar una OU con cuentas
SUSPENDED/CLOSED→ nació laClosedAccountsOU (no registrada, solo sala de espera). No estaba prevista en el diseño. - Account Factory falló con
AdministratorAccess: el acceso al portafolio de Service Catalog es una capa separada de la política IAM. Agregarte al grupoAWSAccountFactorylo arregló… y rompió el acceso a la consola de CT. Solución final: dar acceso al portafolio de Account Factory directamente al rol SSO deAdministratorAccess. - Account Factory la nombró
NetworkingAccount→ renombrada desde Billing → Account settings (Organizations no permite renombrar). - Provider alias ahora asume
AWSControlTowerExecution(noOrganizationAccountAccessRole).terraform apply: 15 recursos, limpio.
8. Primera cuenta de workload: MyWebApp-dev + primer VPC Peering
Todo: ✍️ Escribe aquí
Material en bruto:
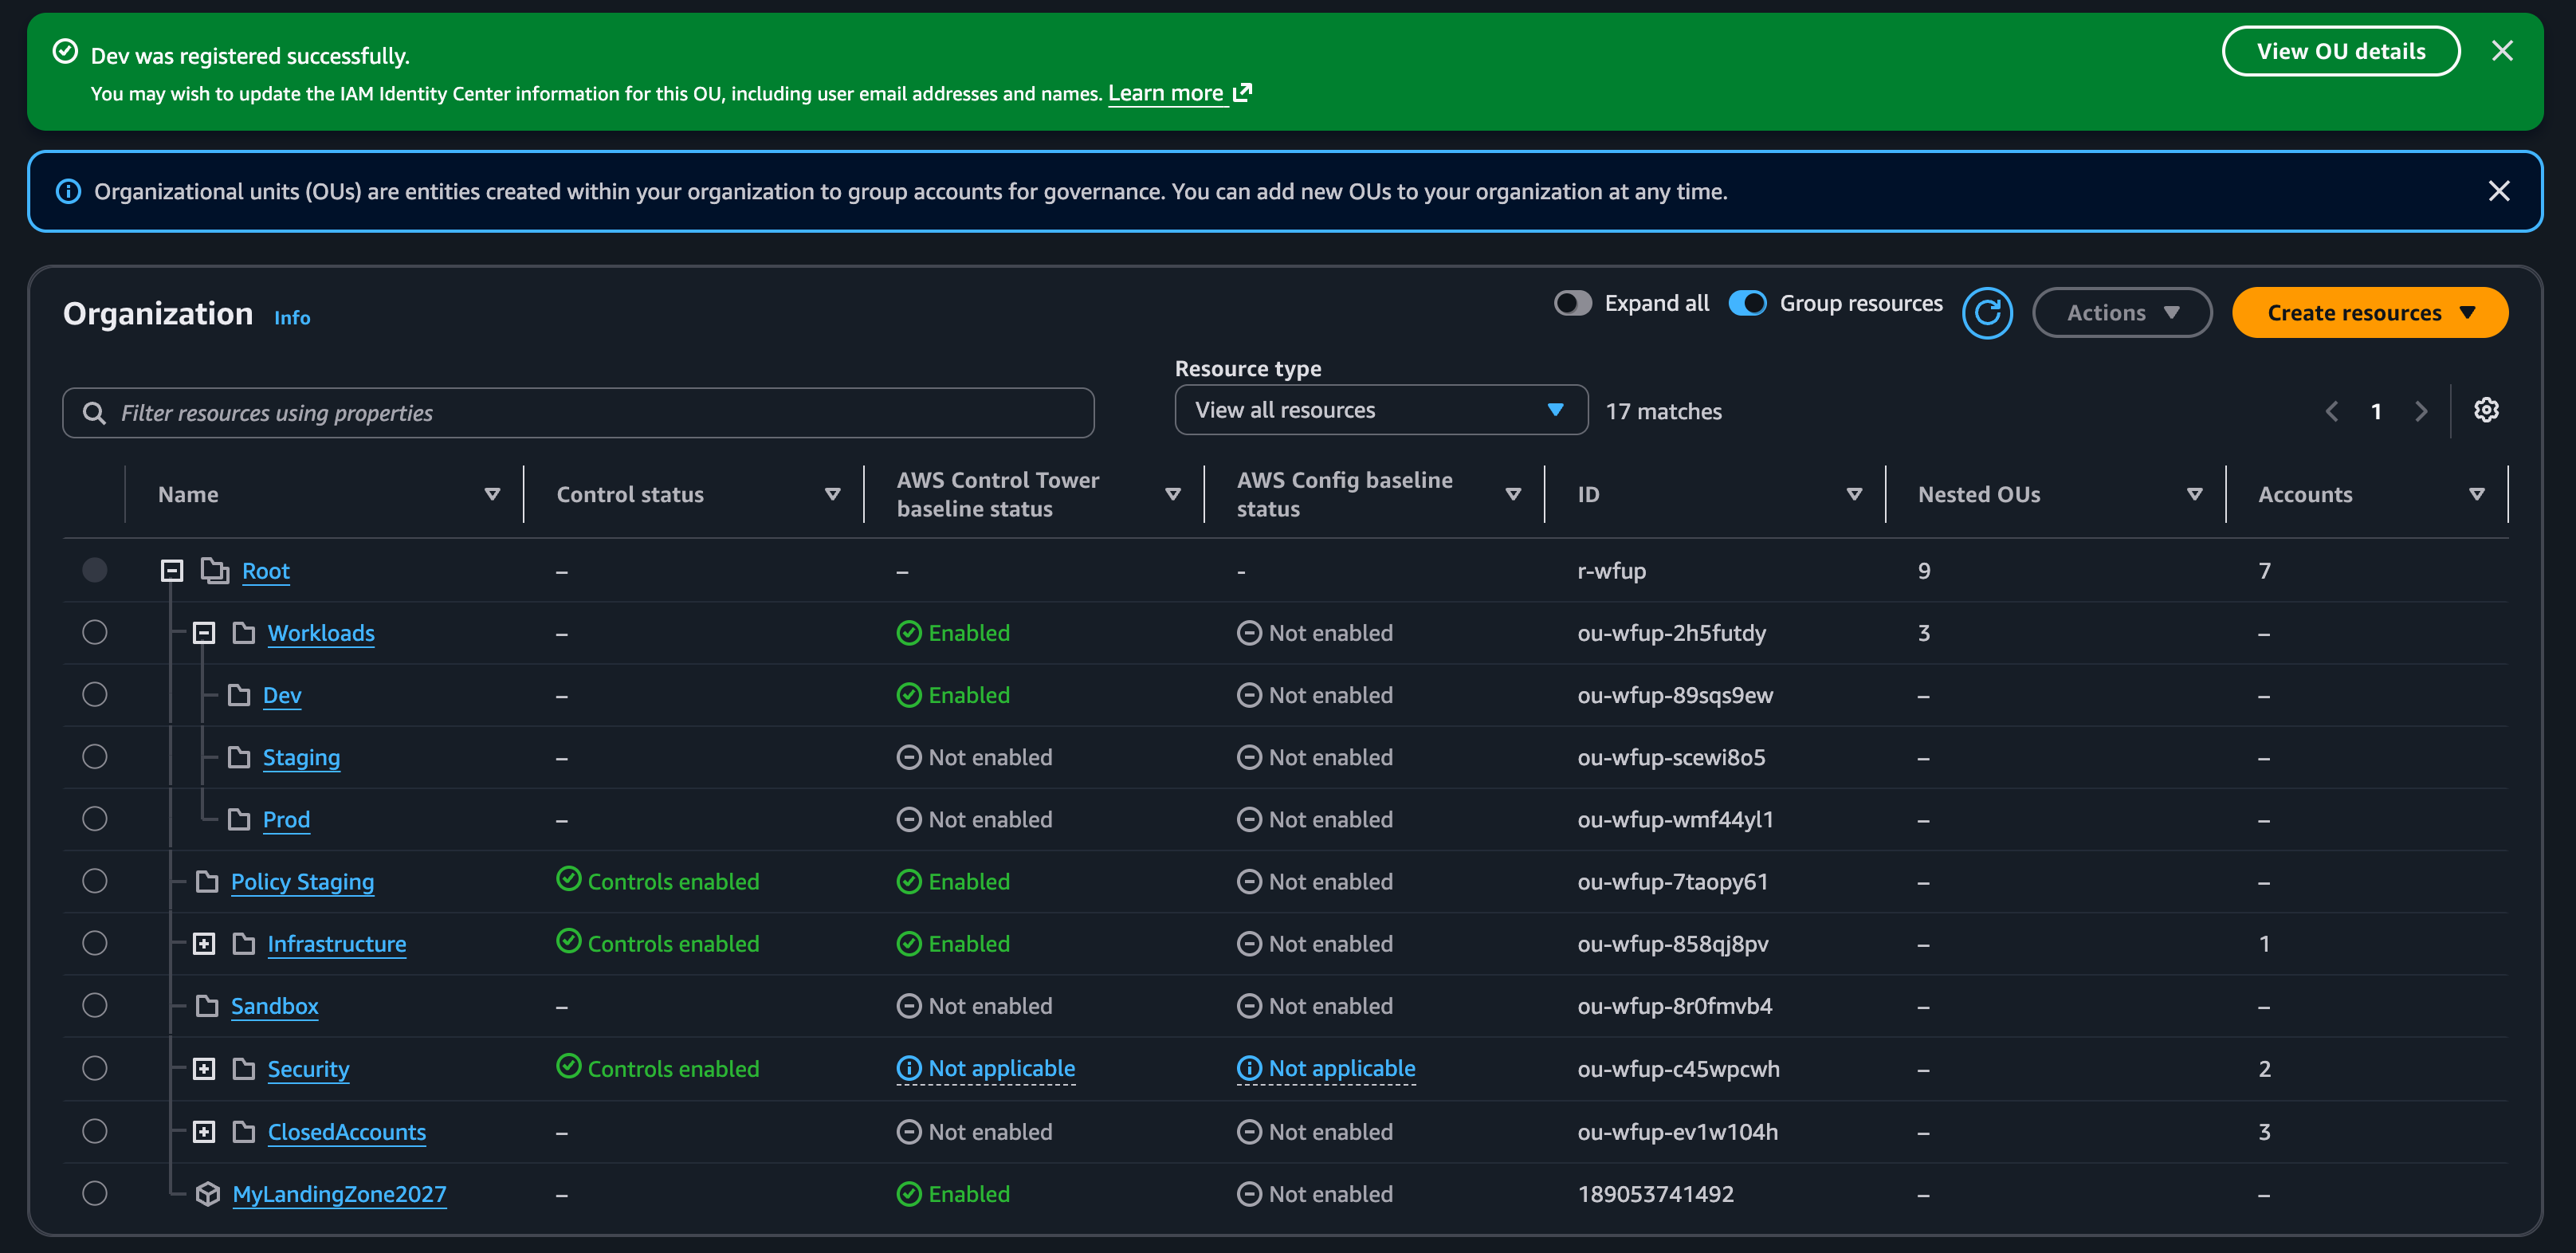
- Registrar
Deven Control Tower exigió registrar primero la OU padreWorkloads— el registro no cae en cascada a las hijas.
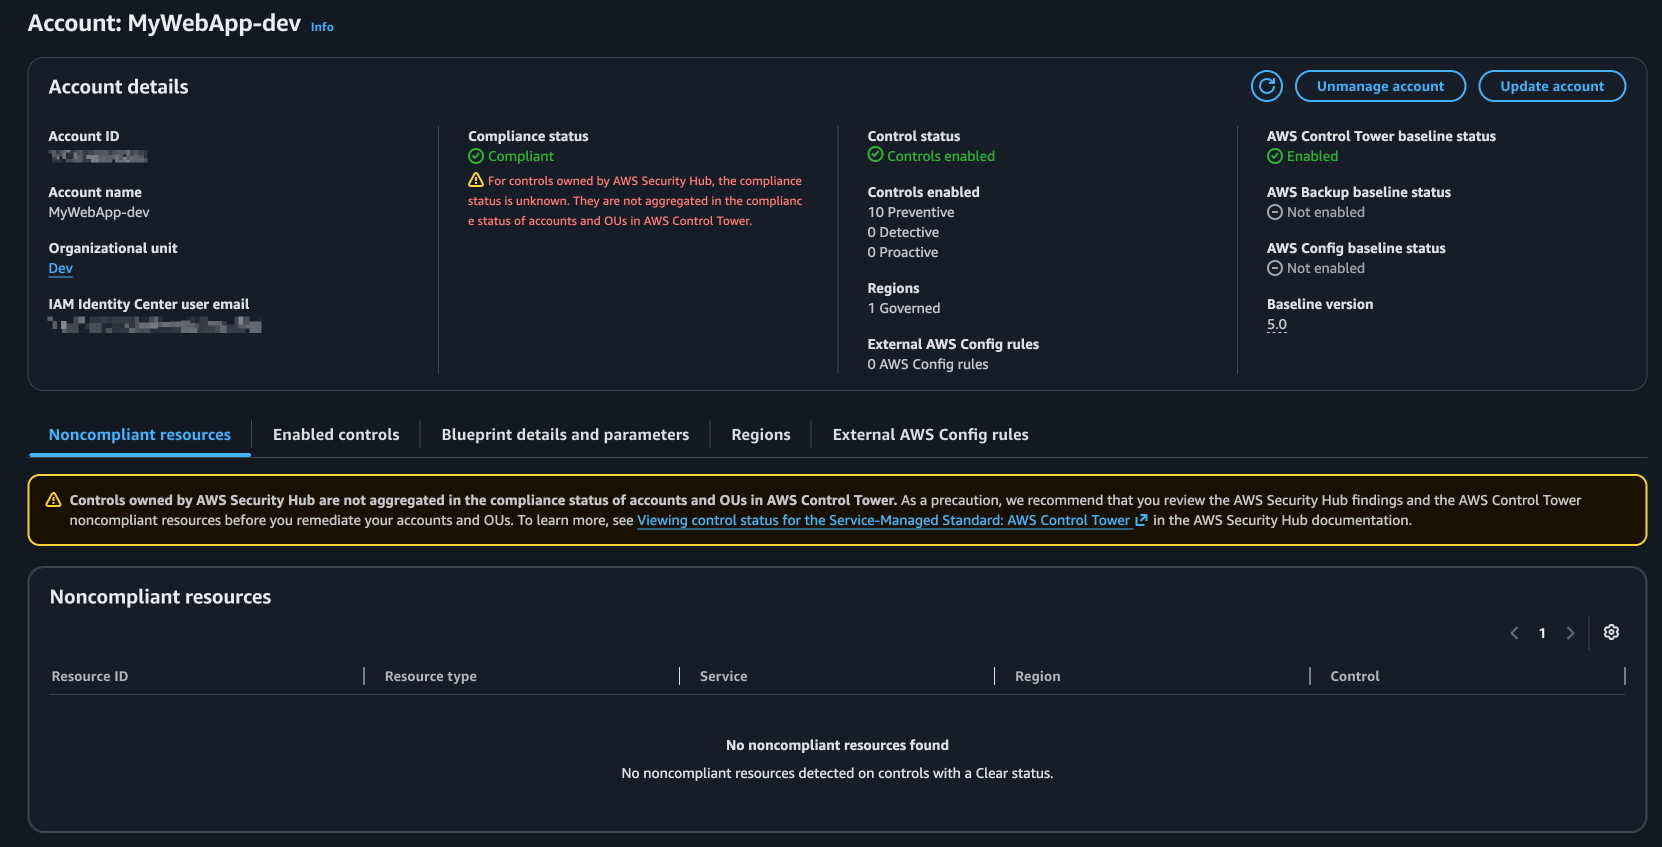
- Cuenta creada con Account Factory en
Workloads/Dev(2026-09-14). Tardó casi 10 min en quedar todo Enabled.
- Guardrails heredados automáticamente al caer en
Dev: SCP #1, #2 y #3, sin crear nada nuevo. - Primera instancia real del módulo
vpc-baseline(CIDR10.0.64.0/20, slot 1 del pool Dev) → 22 recursos. Tuviste que declararrequired_providersen el módulo para quitar un warning del plan. - Peering cross-account hub ↔
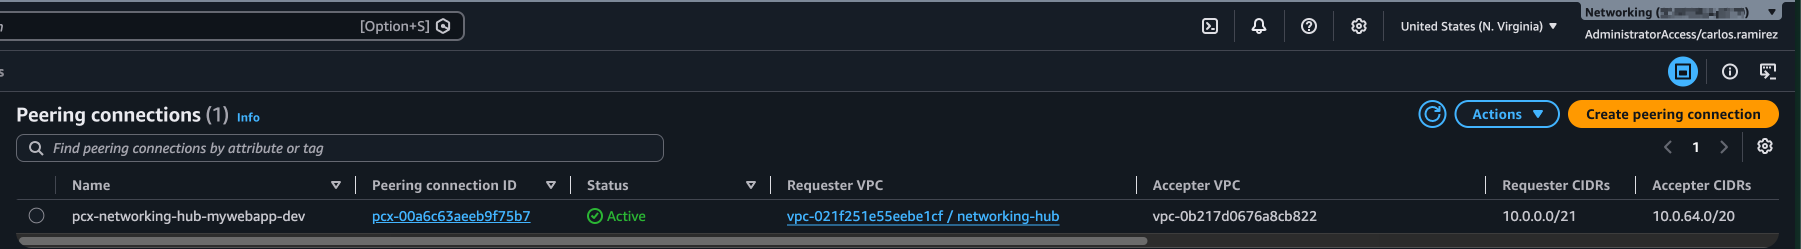
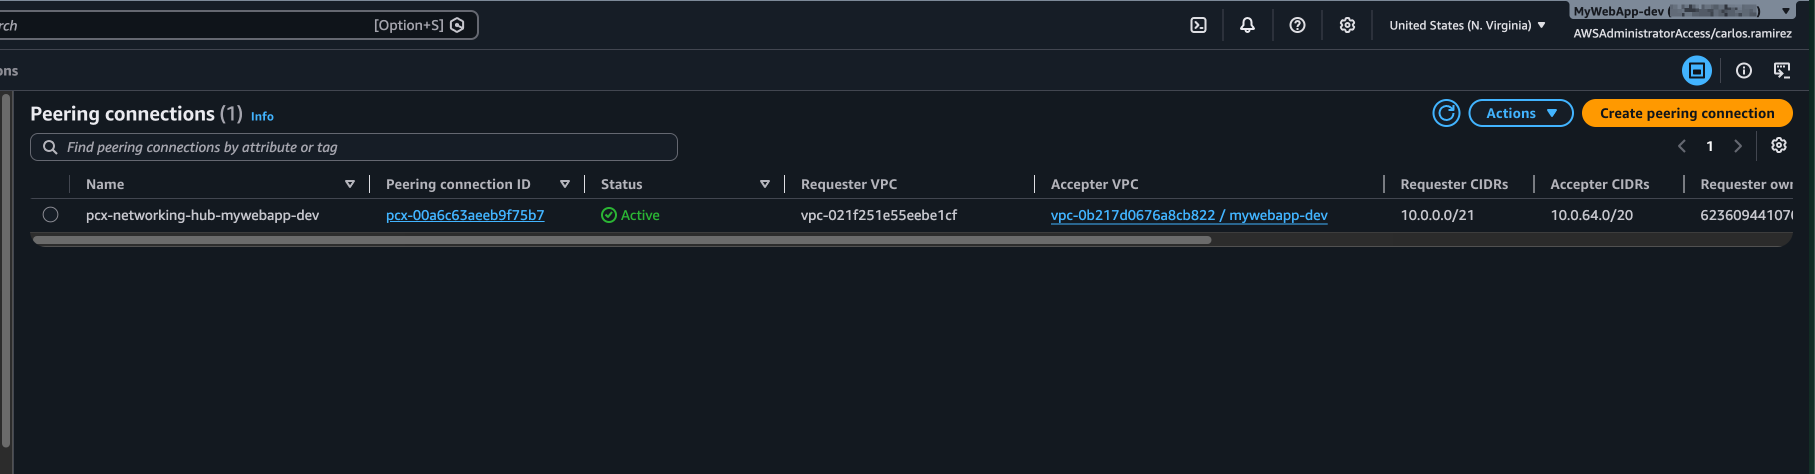
MyWebApp-dev: requester en el hub + accepter explícito en la cuenta nueva (auto_acceptsolo funciona dentro de la misma cuenta). Las rutas de ambos lados llevandepends_onal accepter, porque AWS no deja crear rutas sobre un peering que aún no estáactive.
- El “footgun” de Terraform (buena historia para el post): después de crear el peering, el siguiente
terraform planquería borrar la ruta del peering en la route table pública. Causa: el módulo declaraba la ruta al IGW como bloqueroute { }inline, y eso convierte ese bloque en la única fuente de verdad de toda la tabla — cualquieraws_routeexterno queda marcado para eliminar. Fix: sacar la ruta a un recursoaws_routeseparado e importar la ruta existente (si no,RouteAlreadyExists):
| |
| |
→ No changes. Como el fix quedó en el módulo compartido, Staging/Prod ya no lo van a sufrir.
- Acceso en Identity Center asignado:
platform-admins,developers(por fin una cuenta Dev real para ese grupo) yreadonly-auditors. Crear la cuenta no da acceso a nadie automáticamente.
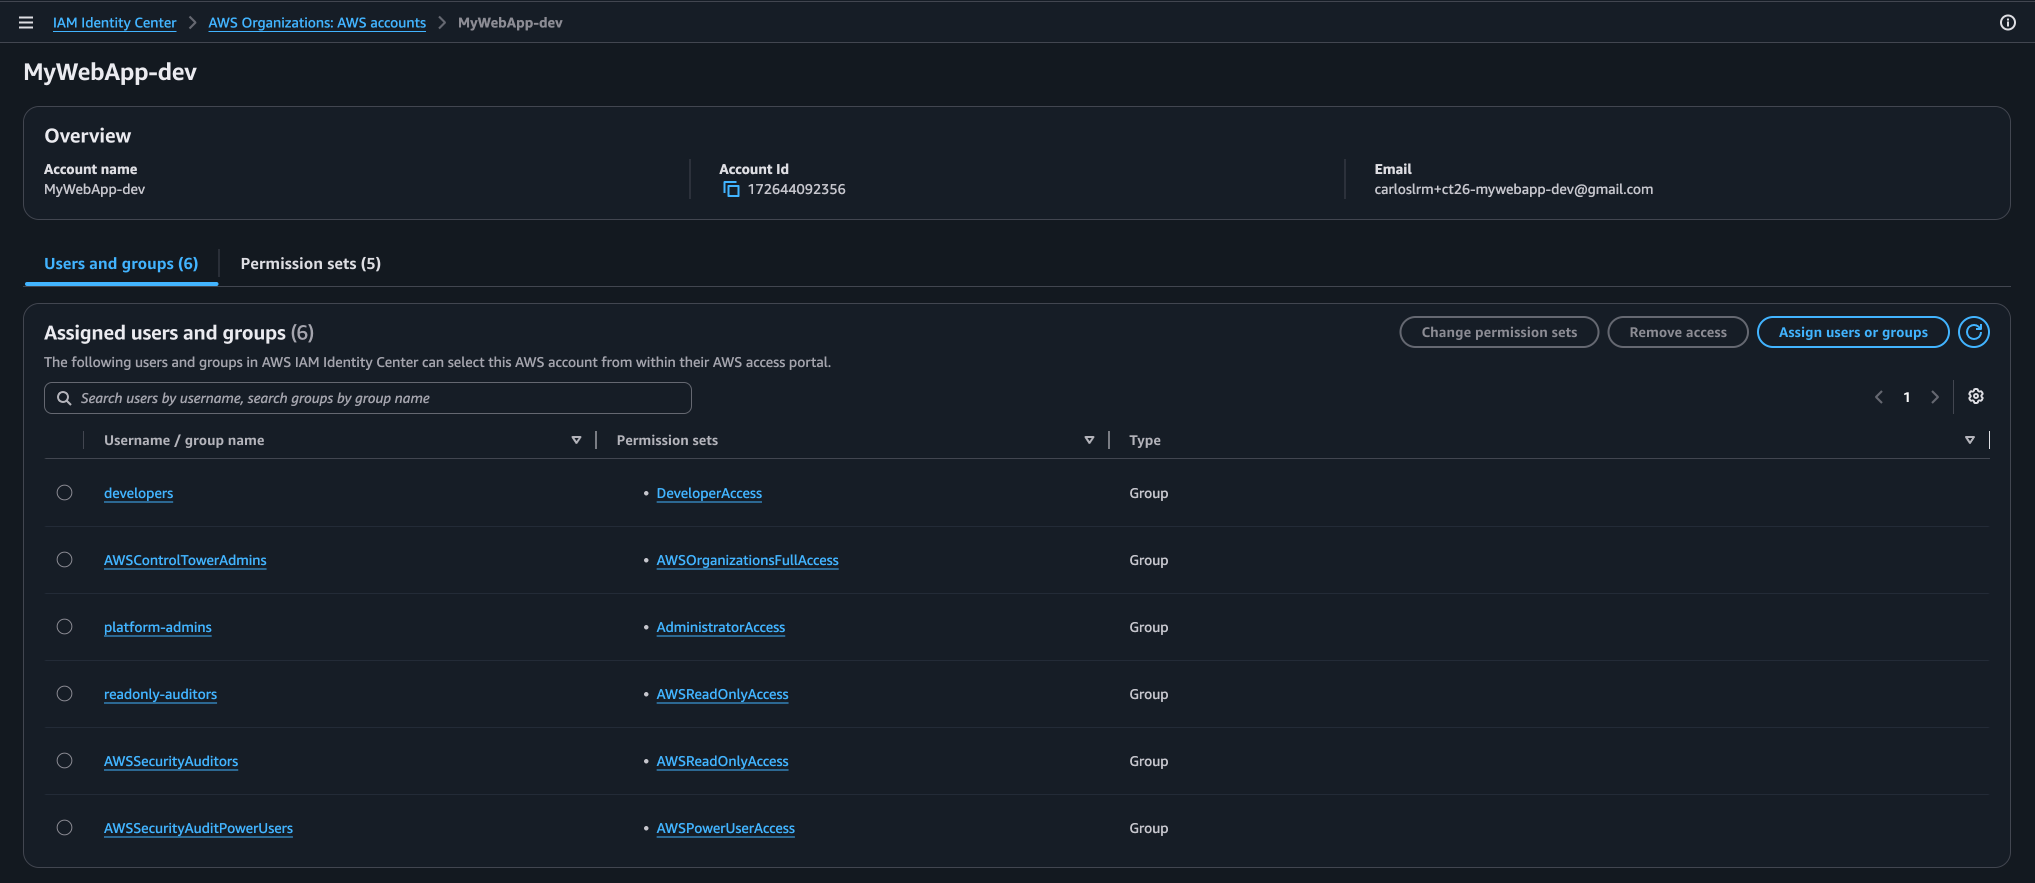
Warning: Esta captura muestra el correo y el Account ID sin redactar. Usa la versión redactada del repo (
docs/evidence/) o redáctala antes de publicar.
- Límite de la landing zone: con esto la cuenta y la red están listas. Security Groups, ALB y EC2 pertenecen al repo de la aplicación, no a la landing zone.
- Decisión de no usar
MyWebApp-devpara probar SCPs: no ensuciar una cuenta real con intentos fallidos a propósito → la verificación se movió aSCP-test(sección 9).
9. Verificar los guardrails de verdad (reabrir SCP-test)
Todo: ✍️ Escribe aquí
Material en bruto:
- El README tenía pendiente desde el 2026-09-03 la evidencia formal (un caso denegado + uno permitido por SCP). La cuenta
SCP-testya estaba cerrada → ticket de soporte para reabrirla (2026-09-14). - Se movió de
ClosedAccountsaPolicy Staging. SCP #2 ya estaba adjunta ahí de forma permanente; #1 y #3 se adjuntaron temporalmente por CLI, fuera de Terraform (un attach de prueba no es una decisión de guardrail permanente → no va en.tf), y luego se desadjuntaron. - Decisión final:
SCP-testqueda activa pero sin uso enPolicy Staging. No se vuelve a cerrar (evita repetir cerrar → ticket → reabrir) ni se manda aClosedAccounts(esa OU no está registrada en CT: tener ahí una cuenta activa le quitaría gobernanza). - Snippets ya saneados para el post (IDs sustituidos, mensaje codificado recortado):
SCP #1 — tipo de instancia no permitido (t3.medium), denegado:
| |
SCP #3 — tipo permitido pero sin tags obligatorios, denegado:
| |
SCP #1 + #3 — tipo permitido y con tags, permitido:
| |
SCP #2 — crear Transit Gateway, denegado:
| |
SCP #2 — mismo servicio, acción de lectura, permitido (el bloqueo es específico, no a todo EC2):
| |
- Estado final de la organización en Control Tower:
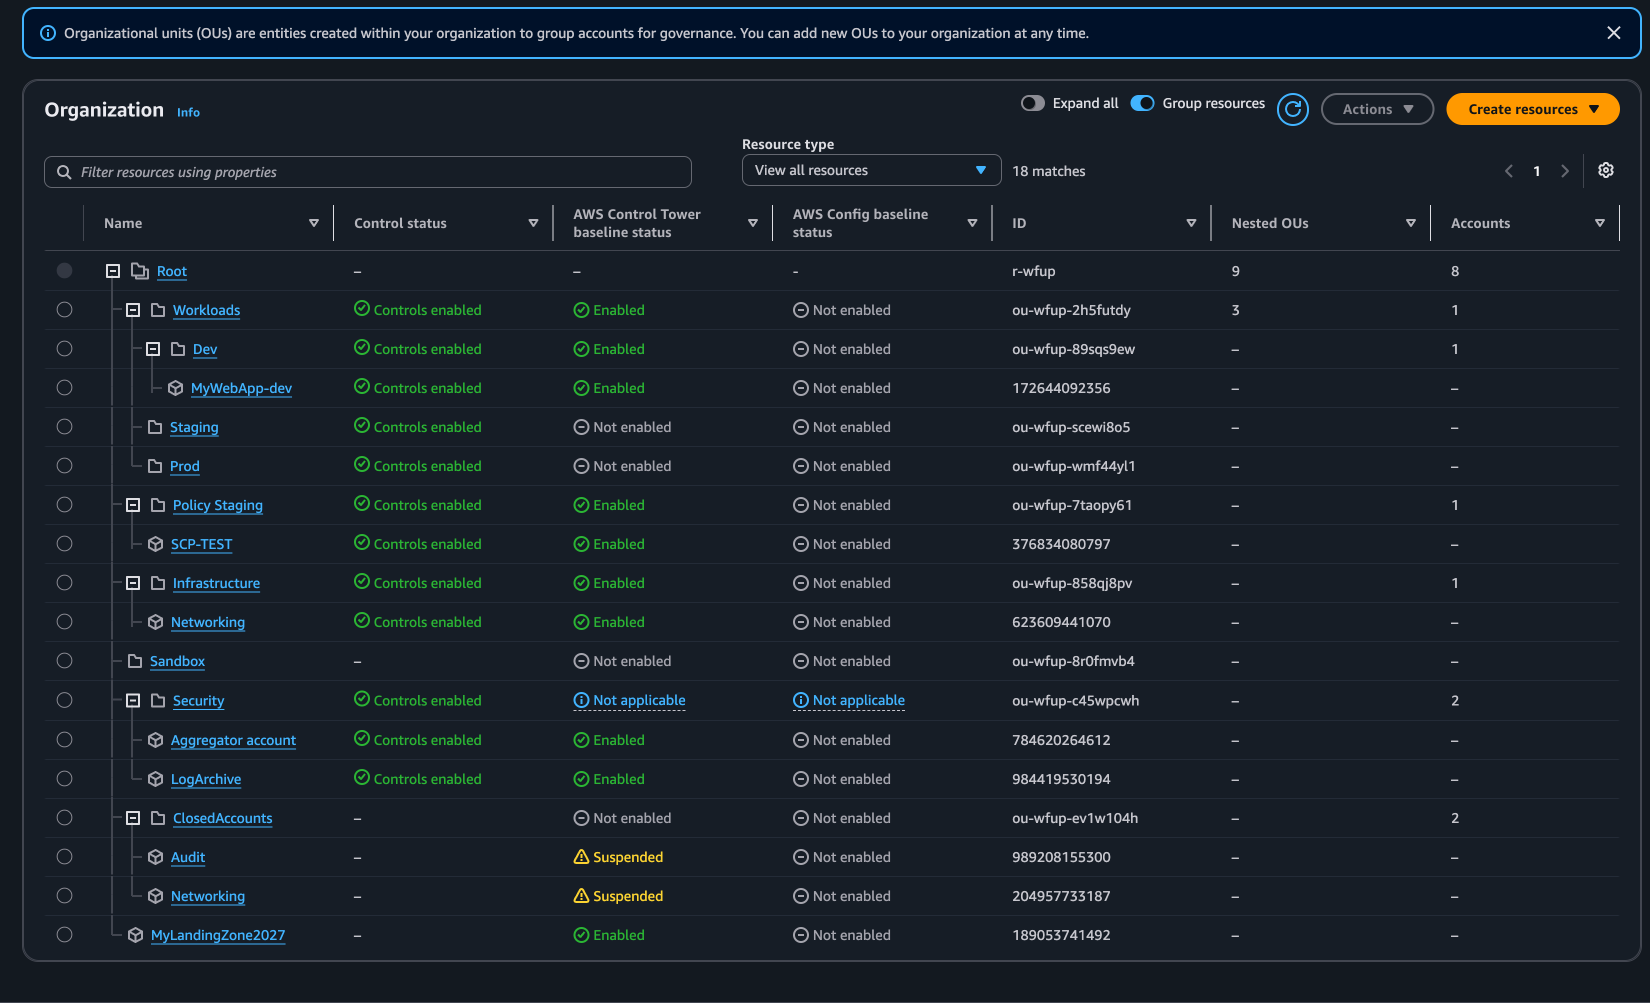
Warning: Esta captura muestra todos los Account IDs y OU IDs. Decide si la redactas o la reemplazas por el árbol en texto de la sección 4.
10. (Opcional) Compartir la landing zone con un proyecto: BrewOps
Todo: ✍️ ¿Entra en este post o queda para el siguiente?
Material en bruto:
MyWebApp-devva a alojar tu proyecto “BrewOps”, con su propia configuración de Terraform (otro repo).- Para que BrewOps lea los IDs de VPC/subnets/peering sin copiarlos a mano: rol
brewops-terraform-state-readeren la cuenta management (la misma del bucket → solo IAM, sin bucket policy), trust limitado a la cuentaMyWebApp-dev,s3:GetObjectsolo sobre el objeto del state. outputs.tfcon un conjunto deliberadamente acotado de valores (el “contrato”).- Lección:
terraform_remote_statesiempre lee el state completo — acotar IAM a un objeto no acota lo que hay dentro. La alternativa que realmente limita exposición es publicar valores en SSM Parameter Store.
11. Lo que aprendí
Todo: ✍️ Escribe aquí — esta sección es la más personal; nadie más la puede escribir
Material en bruto (candidatos, elige 3–5):
- El costo como requisito de diseño, no como reacción (lección del intento anterior).
- Una cuenta creada “fuera” de Control Tower no hereda su baseline → mejor que nazcan con Account Factory.
- Control Tower no registra OUs con cuentas cerradas; el registro no cae en cascada a OUs hijas.
- Service Catalog tiene su propia capa de acceso, separada de IAM.
terraform import+planhasta llegar aNo changesantes de cambiar cualquier comportamiento.- Bloques inline vs. recursos separados en Terraform (el footgun de las rutas).
--dry-runcomo forma barata y limpia de probar SCPs.- Las SCPs no protegen la cuenta management.
terraform_remote_stateexpone todo el state.- Documentar decisiones (ADRs) antes de ejecutar y aceptar que algunas cambian (OUs por entorno, CIDR revisado, alcance de SCPs).
12. Conclusión y próximos pasos
Todo: ✍️ Escribe aquí
Material en bruto:
- Estado: primera iteración completa al 2026-09-18; repositorio público enlazado desde <www.carloslramirez.com>.
- Repo: https://github.com/CarlosLRamirez/aws-multi-account-landing-zone
- Pendiente (posibles “próximos posts”): invitar la cuenta de Route 53 a Infrastructure, crear Shared Services, crear Staging/Prod y peerearlas al hub, desplegar la aplicación en
MyWebApp-dev, posible ADR para el patrón de state compartido. - Llamado a la acción: revisar el repo / dejar preguntas.